Как устроен Deployment в Kubernetes: Pod, ReplicaSet, YAML, RollingUpdate и Recreate. Разбираем проверку обновления, историю ревизий и границы отката.
Чтобы понять, что такое Deployment в Kubernetes, представьте обычное обновление веб-приложения. Нужно запустить новую версию, сохранить нужное число работающих экземпляров и проверить, что изменение завершилось успешно. Deployment описывает желаемый результат и правила замены экземпляров. При этом успешный запуск контейнера еще не означает, что приложение работает правильно, а команда отката не возвращает автоматически базу данных в прошлое состояние.
Разберем устройство Deployment, связь с другими объектами, поля манифеста и порядок проверки обновления. Учебный пример рассчитан на отдельный локальный стенд.
Сегодня искусственный интеллект может стать дополнительным инструментом в работе с Kubernetes и DevOps-процессами. Языковые модели помогают быстрее разбираться в технической документации, находить нужные сведения в инструкциях, анализировать описания ошибок и готовить первичные варианты решений. Это особенно полезно в инфраструктуре, где специалистам приходится учитывать множество взаимосвязанных компонентов и быстро принимать решения при изменениях.
Например, ИИ-помощник можно подключить к внутренней базе знаний команды, чтобы инженеры могли задавать вопросы о настройках окружений, регламентах обновления и типовых причинах сбоев на естественном языке. Такой инструмент не заменяет проверку конфигурации и экспертную оценку, но сокращает время на поиск информации, помогает структурировать данные об инциденте и упрощает подготовку технических материалов.
Для создания подобных сценариев можно использовать «Улей» — облачный сервис языковых моделей компании Nubes. Он предоставляет доступ к разным моделям через единый OpenAI-совместимый API, поддерживает выбор модели под задачу, интеллектуальную маршрутизацию запросов и контроль потребления. На его основе можно, например, создать ИИ-помощника для поиска по технической документации и инструкциям или разбора заявок и инцидентов, постепенно проверяя и расширяя такие сценарии.
Что такое Deployment в Kubernetes
Deployment — API-объект, в котором задают желаемое состояние набора Pod: шаблон запуска, число реплик и стратегию обновления. Контроллер Deployment наблюдает за этим описанием и организует переход от текущего состояния к заданному. Такой подход называют декларативным: пользователь описывает результат, а управляющие компоненты выполняют необходимые изменения.
Например, в конфигурации можно указать две реплики веб-приложения и определенный образ контейнера. Если поменять образ в шаблоне Pod, начнется обновление. Если изменить только количество реплик, произойдет масштабирование. Для контроллера это разные действия, хотя оба задаются через один объект.
Deployment обычно используют для приложений, экземпляры которых можно заменять без сохранения уникальной локальной идентичности: веб-сервисов, API и некоторых фоновых обработчиков. Это не означает, что приложение вообще не работает с данными. Важно, где хранится состояние и что произойдет при замене отдельного Pod.
Механика описана в официальной документации Deployment. В примерах ниже используется стабильный API apps/v1; особенности управления сверены с веткой документации Kubernetes 1.37. Версия API объекта и версия установленного кластера — разные обозначения.
Как связаны Deployment, ReplicaSet, Pod и Service
Pod — минимальная единица, которую Kubernetes размещает на узле. Внутри него может работать один контейнер или несколько связанных контейнеров. Они используют общую сеть Pod и могут совместно обращаться к подключенным томам. Сам Pod не следует воспринимать как неизменяемую виртуальную машину: при замене создается другой объект с новой идентичностью.
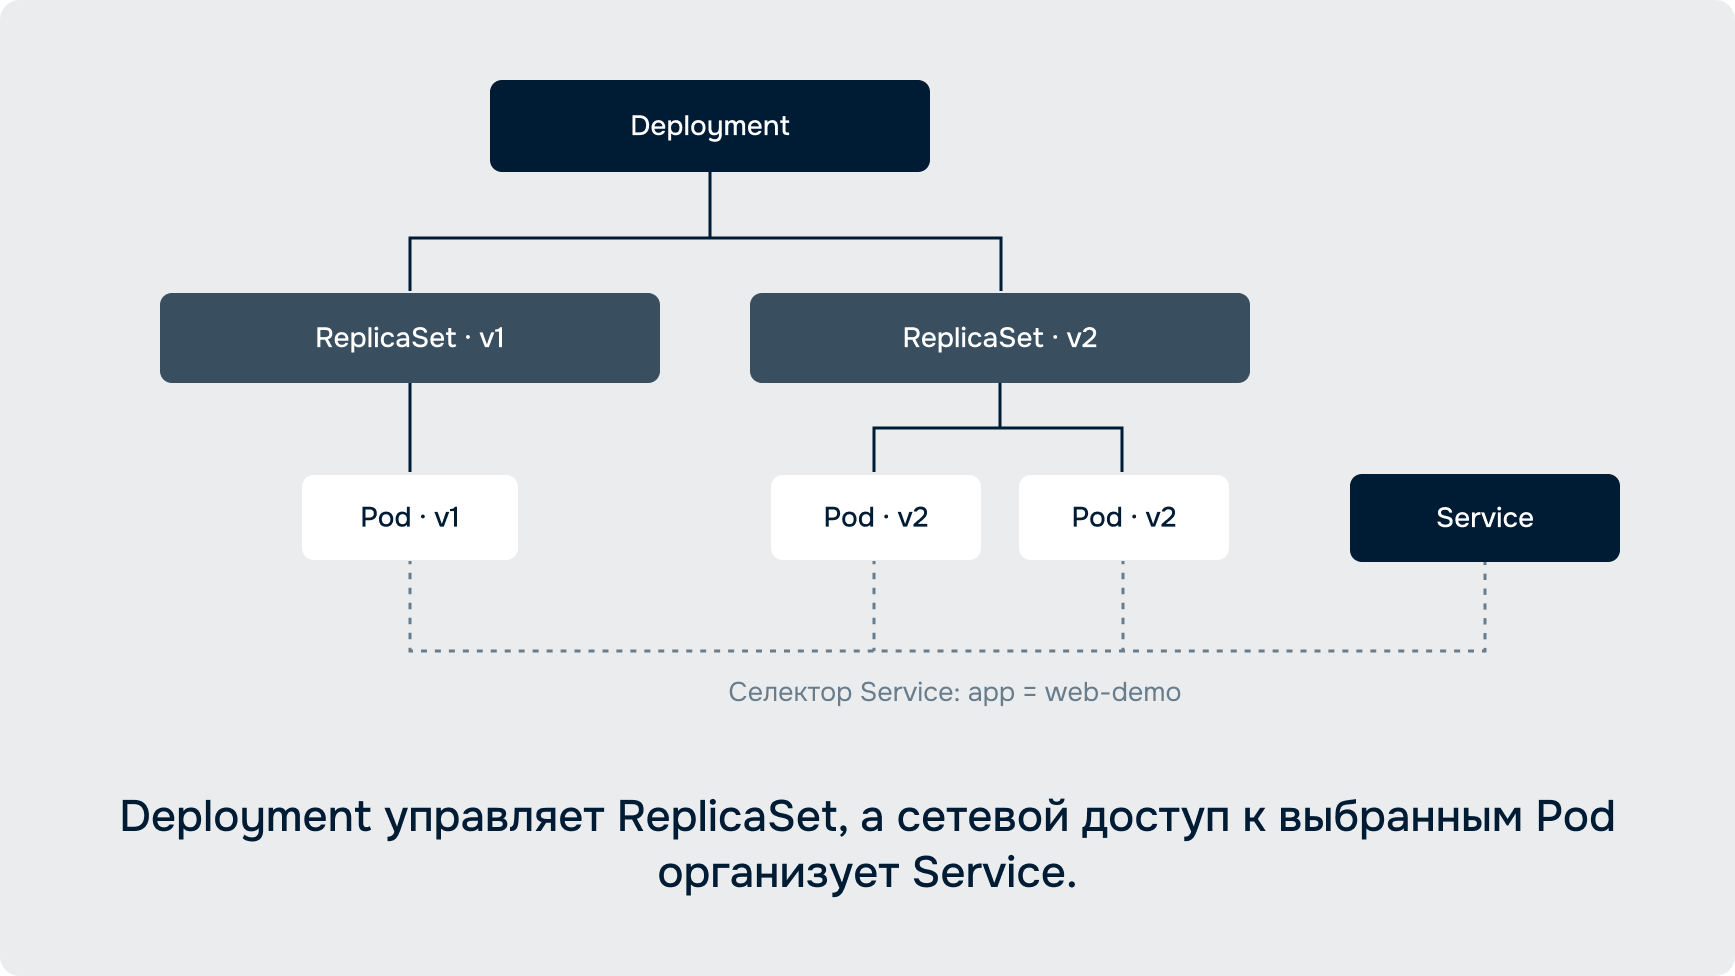
ReplicaSet поддерживает заданное число подходящих Pod. Deployment управляет ReplicaSet и при обновлении распределяет число реплик между старым и новым набором. Не стоит независимо изменять ReplicaSet, принадлежащий Deployment: это создает конкурирующие представления о желаемом состоянии.
Здесь полезно разделять восстановление разных уровней. Перезапуск завершившегося контейнера внутри существующего Pod выполняет kubelet с учетом политики перезапуска. Если необходим новый Pod, его создание связано с контроллером ReplicaSet, а выбор узла — с планировщиком. Формулировка «Deployment переносит контейнер на другой сервер» скрывает эти различия и создает ожидание мгновенного переноса.
Service решает другую задачу: предоставляет устойчивую точку сетевого обращения к выбранным Pod. Его селектор связывает сервис с нужными метками. Deployment не создает Service автоматически, а поле containerPort в шаблоне не публикует приложение во внешней сети. Внутренний и внешний доступ проектируют отдельно.
Если нужна общая картина платформы, полезно сначала посмотреть, как работает Kubernetes. Для понимания обновления достаточно запомнить цепочку: Deployment управляет наборами реплик, ReplicaSet поддерживает Pod, а Service выбирает конечные точки для сетевого доступа.
Как читать манифест Deployment
Манифест — описание объекта в YAML или JSON. Его полезно читать не как набор обязательных строк для копирования, а как контракт: что приложение должно запускать, как его находить и какие изменения допустимы при обновлении.
Обязательные поля и число реплик
В начале указывают apiVersion: apps/v1, kind: Deployment и имя в metadata.name. Пространство имен помогает отделить объекты разных приложений или сред. Далее находится spec — желаемая конфигурация, включая число реплик и шаблон Pod.
Поле replicas задает нужное количество экземпляров. Это не обещание, что столько экземпляров всегда будет готово обслуживать запросы: запуск может остановиться из-за отсутствующего образа, нехватки ресурсов или ошибки приложения. Текущее состояние нужно читать отдельно от спецификации.
| Поле | Что описывает | На что обратить внимание |
|---|---|---|
| metadata.name | Имя объекта | Команды должны обращаться к нужному объекту и пространству имен |
| spec.replicas | Желаемое число реплик | Отличать от готовых и доступных экземпляров |
| spec.selector | Какие Pod принадлежат набору | Согласовать с метками шаблона; в apps/v1 селектор неизменяем |
| spec.template | Как создавать Pod | Изменение этого шаблона запускает новую ревизию |
| spec.strategy | Как заменять реплики | Выбрать допустимое сочетание старой и новой версий |
Метки, селектор и шаблон Pod
Метки — пары ключ–значение, по которым объекты можно находить и группировать. Селектор Deployment должен соответствовать меткам в template.metadata.labels. Иначе спецификация не описывает согласованный набор Pod. Для уже созданного объекта нельзя просто поменять spec.selector: смену границ набора нужно проектировать отдельно.
В template.spec находятся контейнеры, их образы, ресурсы, переменные окружения, проверки и другие настройки запуска. При изменении шаблона Pod создается новая ревизия Deployment. Простое увеличение replicas новой ревизии не создает. Это различие важно, когда после масштабирования ожидают увидеть дополнительную запись в истории обновлений.
Не следует назначать пересекающиеся селекторы независимым контроллерам для одних и тех же экземпляров. Также стоит проверить Service: корректный селектор Deployment еще не означает, что сетевой сервис выбирает те же Pod. Ошибка метки способна сделать исправно работающее приложение недоступным по ожидаемому адресу.
Как проходит обновление приложения
Обновление, или rollout, начинается при изменении шаблона Pod. Контроллер создает новый ReplicaSet и управляет переходом между наборами в соответствии со стратегией. Старые экземпляры не редактируются на месте: новые Pod получают новую конфигурацию запуска.
RollingUpdate и Recreate
У Deployment две встроенные стратегии. RollingUpdate постепенно заменяет старые экземпляры новыми. В переходный период могут одновременно работать разные версии приложения, поэтому они должны быть совместимы с общими зависимостями и протоколами.
Recreate предполагает удаление старого набора перед созданием нового в ходе обновления. Этот вариант подходит, когда совместная работа версий недопустима и остановка приемлема для выбранного сценария. При этом он сам по себе не решает миграцию схемы БД, перенос файлов или согласование внешних процессов.
| Стратегия | Переход между версиями | Основное условие |
|---|---|---|
| RollingUpdate | Постепенная замена, возможна совместная работа | Совместимость версий и достаточный запас ресурсов |
| Recreate | Сначала удаление старого набора, затем запуск нового | Допустимая остановка и продуманный порядок работы с состоянием |
Canary и blue-green — более широкие схемы выпуска, а не дополнительные значения поля spec.strategy.type. Для них отдельно организуют наборы, маршрутизацию и критерии переключения. Их не стоит приписывать обычному Deployment как встроенный автоматический анализ качества новой версии.
Что задают maxSurge и maxUnavailable
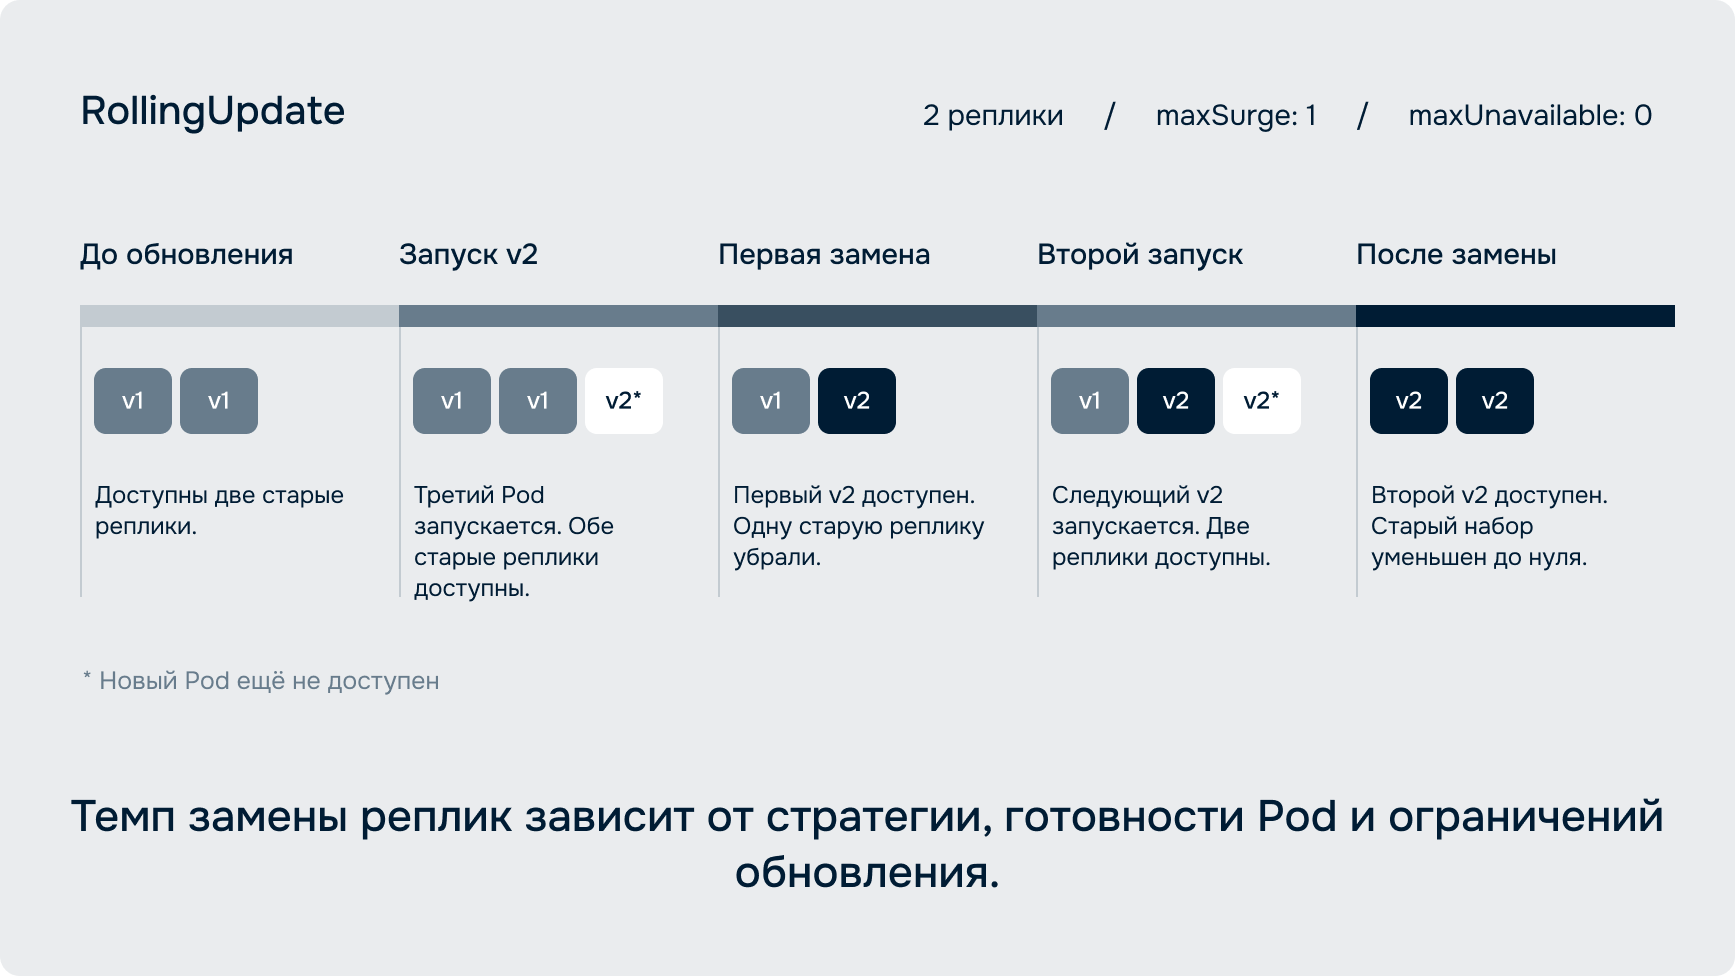
При RollingUpdate параметр maxSurge ограничивает планируемое увеличение числа реплик сверх желаемого количества, а maxUnavailable — допустимое уменьшение доступных реплик во время обновления. Значения задают количеством или процентом. Их выбирают совместно: нельзя одновременно установить оба ограничения в ноль.
Например, при двух репликах, maxSurge: 1 и maxUnavailable: 0 контроллер может сначала добавить экземпляр новой версии, дождаться его доступности и затем уменьшать старый набор. Для этого нужен запас ресурсов. Если разместить дополнительный Pod невозможно, переход может остановиться.
Это не жесткий предел общего потребления ресурсов всеми процессами. Завершающиеся Pod могут еще освобождать соединения и память, поэтому во время перехода необходимо учитывать и их. Также параметры стратегии не защищают от независимого отказа узла, нехватки квоты или ошибки прикладной логики.
Что проверить для обновления без простоя
RollingUpdate помогает управлять заменой реплик, но фраза «обновление без простоя» требует дополнительных условий. Должны быть работоспособны само приложение, сетевой путь, зависимости и обработка завершающихся запросов.
Готовность реплик и прикладные проверки
Readiness probe показывает, готов ли контейнер обслуживать запросы. При обычной настройке Service не должен направлять новый трафик на неготовые конечные точки. Если проверка отвечает успехом до завершения инициализации, трафик может прийти слишком рано.
Liveness probe решает другую задачу: помогает выявить состояние, из которого контейнер не восстанавливается сам и для которого нужен перезапуск. Ошибочная проверка способна перезапускать приложение во время нормального долгого старта. Для такого старта предусмотрена startup probe. Различия описаны в документации о проверках контейнеров.
Полезно проверять не только факт ответа HTTP-порта, но и готовность приложения выполнять свою работу. При этом проверки должны оставаться устойчивыми: временная проблема внешней зависимости не всегда означает, что перезапуск контейнера полезен. Отдельные прикладные тесты после выпуска дополняют probes.
Поле minReadySeconds задает время непрерывной готовности перед тем, как новая реплика считается доступной для целей Deployment. Оно не выполняет бизнес-тесты и не измеряет пользовательское качество. Смысл этого ожидания — дать экземпляру показать устойчивую готовность в течение выбранного интервала.
Ресурсы, завершение соединений и совместимость версий
Запросы ресурсов, ограничения, квоты и правила размещения должны позволять запустить новые Pod. Наличие свободной памяти на одном узле еще не доказывает, что планировщик сможет разместить экземпляр с заданными требованиями. Ограничения по узлам и другие нагрузки тоже участвуют в решении.
При остановке старой реплики приложение должно корректно завершать работу: перестать принимать новые операции и дать закончиться тем, которые уже выполняются. Период завершения предоставляет для этого время, но не пишет обработчик остановки вместо разработчика. Долгие соединения и фоновые задачи требуют отдельной проверки.
Во время перехода старая и новая версии могут обращаться к одной базе данных. Если миграция удалила колонку, необходимую старому коду, стратегия замены реплик не исправит несовместимость. План выпуска должен учитывать порядок изменения схемы и возможность безопасного возврата. Иногда для этого нужны поэтапные совместимые изменения.
Локальный учебный пример Deployment
Предположим, что есть отдельный локальный кластер с контекстом training и заранее созданным пространством имен deployment-demo. В его узлы загружены учебные образы training-web:1.0 и training-web:1.1. Приложение слушает порт 8080 и возвращает успешный ответ по /ready, когда готово принимать запросы.
Манифест приложения
В файле deployment-demo.yaml можно описать следующий объект:
apiVersion: apps/v1
kind: Deployment
metadata:
name: web-demo
namespace: deployment-demo
spec:
replicas: 2
revisionHistoryLimit: 3
minReadySeconds: 5
progressDeadlineSeconds: 120
selector:
matchLabels:
app: web-demo
strategy:
type: RollingUpdate
rollingUpdate:
maxSurge: 1
maxUnavailable: 0
template:
metadata:
labels:
app: web-demo
spec:
containers:
- name: web
image: training-web:1.0
imagePullPolicy: Never
ports:
- containerPort: 8080
resources:
requests:
cpu: 100m
memory: 64Mi
limits:
cpu: 500m
memory: 256Mi
readinessProbe:
httpGet:
path: /ready
port: 8080
periodSeconds: 5
Здесь imagePullPolicy: Never намеренно запрещает загрузку из registry. Если нужного образа нет на узле, запуск не состоится. Для локального стенда образы нужно подготовить заранее и сделать доступными каждому узлу, на котором может появиться Pod. Для рабочей инфраструктуры способ доставки и проверки образов проектируют отдельно.
Значения CPU, памяти и интервалов не являются рекомендацией по размеру сервера. Они только делают поля примера конкретными. Реальные параметры подбирают по поведению приложения и замерам. Правила использования локальных образов и закрепления версии по digest описаны в документации Kubernetes об образах.
Проверка состояния и изменение образа
Следующие команды иллюстрируют работу только с указанным учебным контекстом. Имя контекста и область изменения нужно проверять до применения любого манифеста:
kubectl --context=training -n deployment-demo apply -f deployment-demo.yaml
kubectl --context=training -n deployment-demo get deployment web-demo
kubectl --context=training -n deployment-demo get rs -l app=web-demo
kubectl --context=training -n deployment-demo get pods -l app=web-demo
kubectl --context=training -n deployment-demo rollout status deployment/web-demo --timeout=180s
В выводе важно различать желаемые, обновленные, готовые и доступные реплики. Фаза Pod Running не равна готовности приложения: контейнер может быть запущен, но еще не проходить проверку readiness. Для разбора конкретной проблемы дополнительно смотрят события и состояние отдельного экземпляра.
Чтобы описать обновление, в исходном YAML меняют training-web:1.0 на training-web:1.1, сохраняют файл и снова применяют его к учебному объекту. Меняется Pod template, поэтому появляется новая ревизия и новый ReplicaSet. После этого повторяют проверку rollout и прикладного поведения.
В рабочем процессе изменения обычно хранят в системе контроля версий. Если конфигурацией управляет автоматизированный процесс, важно понимать, какой источник считается желаемым состоянием: ручная команда и версия в репозитории могут разойтись.
Как откатить Deployment
Откат полезен, когда новая версия не проходит проверку и есть совместимая сохраненная конфигурация. Сначала нужно определить, к какой ревизии возвращаться и что изменилось за пределами шаблона Pod.
История ревизий и команда undo
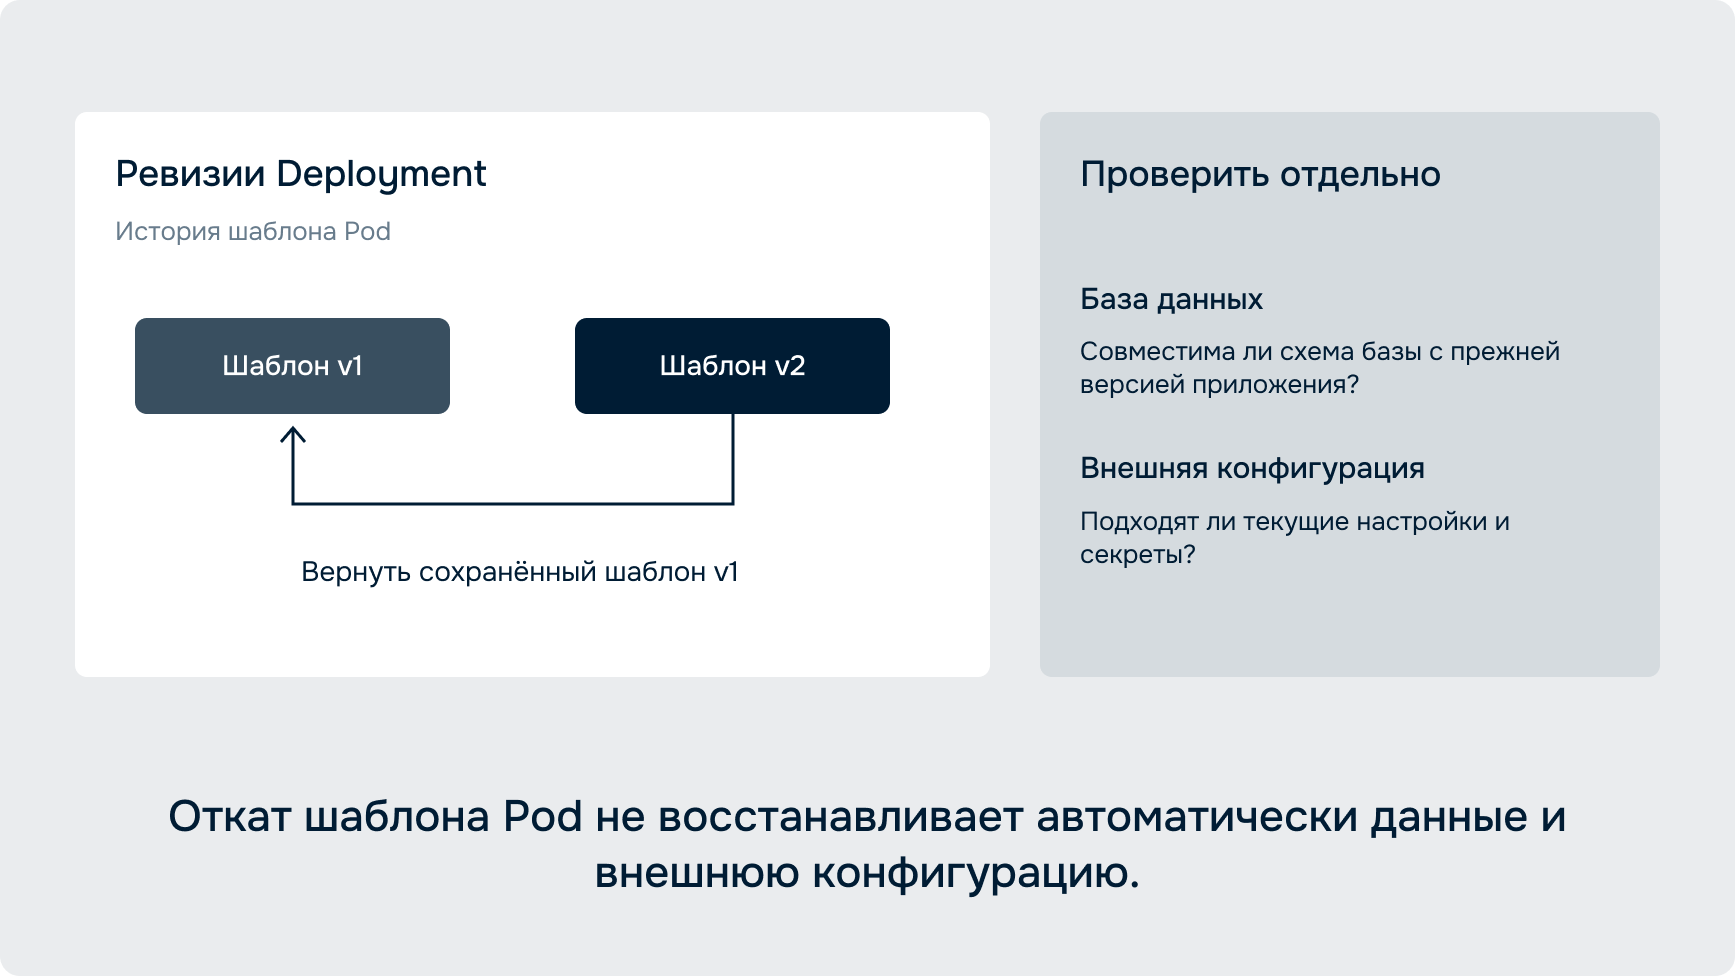
История ревизий хранится в управляемых ReplicaSet. Ее сохранение ограничивается revisionHistoryLimit. Если нужный старый ReplicaSet уже удален, возврат к этой ревизии через историю объекта недоступен. Поэтому «откатиться всегда можно» — неверное ожидание.
В учебной среде историю и возврат к выбранной ревизии показывают такие команды:
kubectl --context=training -n deployment-demo rollout history deployment/web-demo
kubectl --context=training -n deployment-demo rollout undo deployment/web-demo --to-revision=1
kubectl --context=training -n deployment-demo rollout status deployment/web-demo --timeout=180s
Номер 1 здесь иллюстративный: в реальной истории нужно выбрать фактически существующую подходящую запись. После возврата проверяют образ, готовность реплик и работу приложения.
Если выполнялся ручной откат, его нужно согласовать с исходным манифестом и процессом доставки. Иначе следующее применение конфигурации может снова описать проблемную версию. Откат — такое же изменение состояния, которое должно быть понятно команде и отражено в ее рабочем источнике.
Что откат не возвращает
Deployment возвращает прежнюю версию шаблона Pod, а не снимок всей системы. Он не отменяет операции пользователя, миграции схемы, изменения данных во внешней БД или содержимое сетевого хранилища. Не следует путать историю Deployment с резервной копией приложения и его данных.
Похожая проблема возникает с внешней конфигурацией. Если Pod ссылается на ConfigMap или Secret с прежним именем, а содержимое этого объекта изменилось, возврат шаблона сам по себе не восстанавливает старые значения. Стратегию версионирования конфигурации и ее связь с релизом нужно продумывать отдельно.
С образом контейнера тоже важна воспроизводимость. Изменяемый тег может указывать уже на другое содержимое. Для рабочего выпуска полезно иметь однозначный идентификатор артефакта, например закрепленный digest, и проверенный порядок его доставки. Тогда команда понимает, какой код должна получить при возврате.
Как найти причину неудачного rollout
Неудачное обновление не всегда означает, что приложение целиком недоступно. Старые реплики могут продолжать обслуживать запросы, пока новая версия не становится готовой. И наоборот: нужное количество готовых экземпляров еще не доказывает корректность всех бизнес-операций.
Статус обновления и события
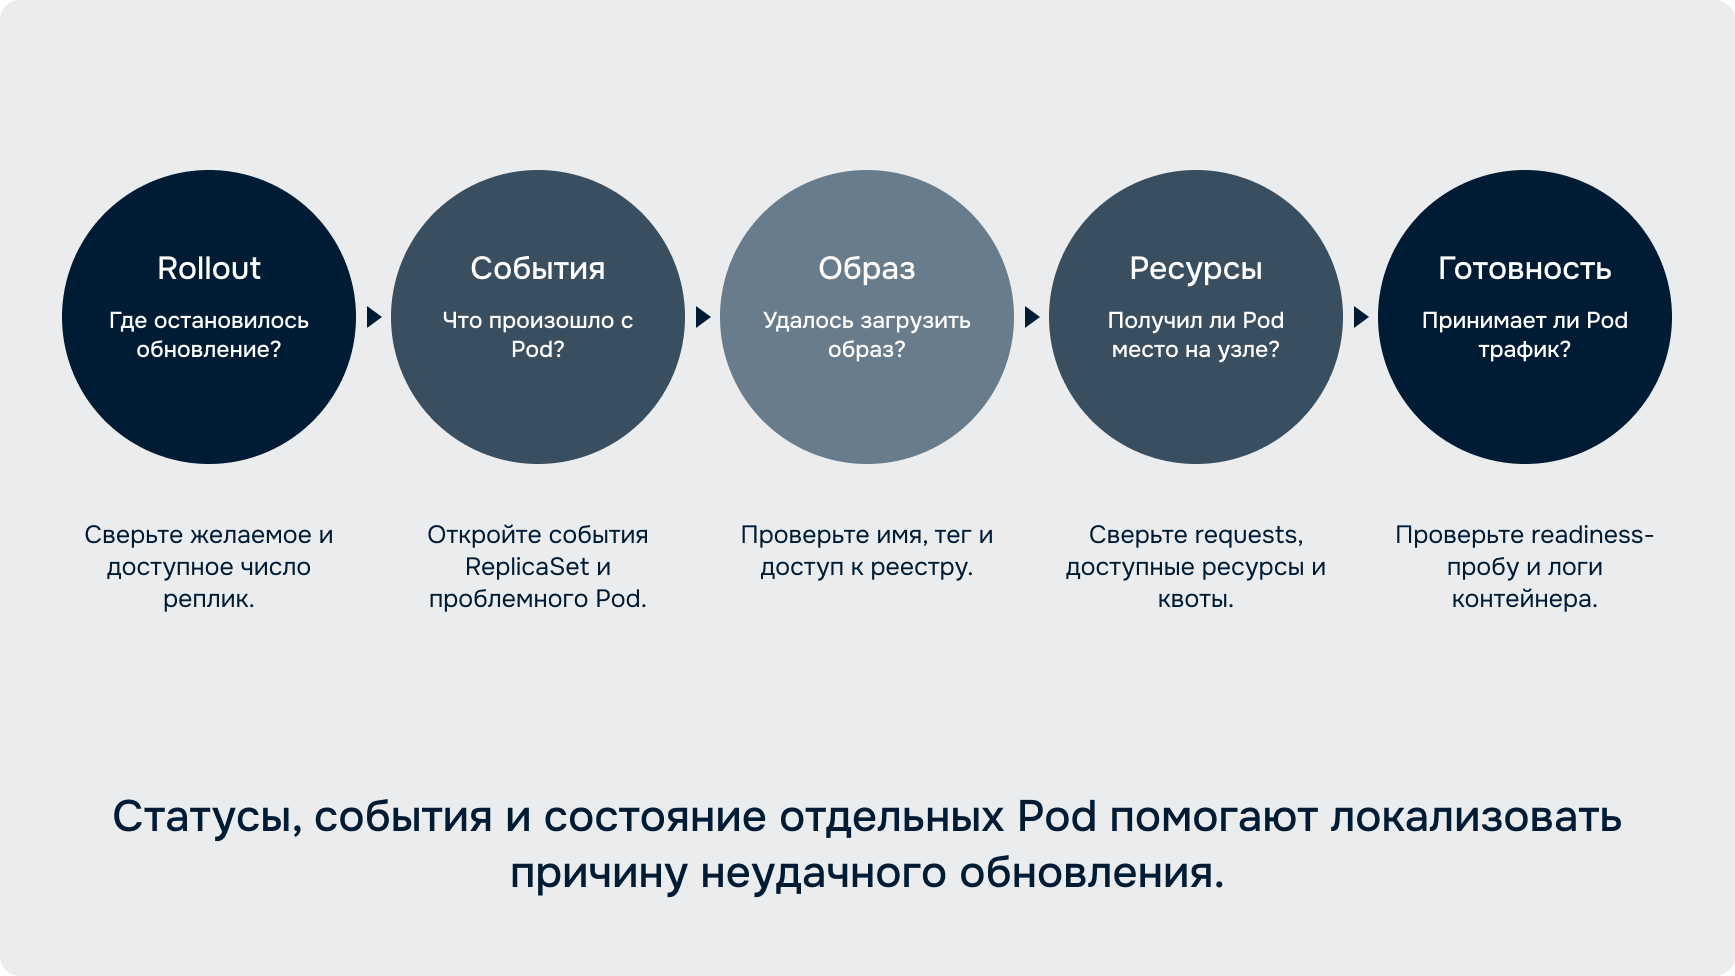
Проверку начинают с kubectl rollout status и состояния Deployment. При необходимости смотрят подробное описание объекта и события. Затем переходят к новому ReplicaSet и его Pod: на каком этапе остановился путь от спецификации до готового приложения.
Поле progressDeadlineSeconds задает предел ожидания прогресса перед сообщением о проблеме. При его превышении появляется условие с причиной ProgressDeadlineExceeded. Контроллер продолжает пытаться привести состояние к заданному; дальнейшее решение принимает оператор или отдельный процесс выпуска.
Не стоит сразу менять все параметры. Сначала нужно понять, не создается ли экземпляр вообще, не может ли он разместиться, не запускается ли контейнер или только не проходит проверку готовности. Для каждой ситуации нужны разные данные и действия.
Типичные ошибки и последовательность проверки
| Наблюдение | Что проверить в первую очередь |
|---|---|
| Новый Pod не удается разместить | Запросы ресурсов, квоты, ограничения размещения и доступную емкость |
| Образ недоступен | Имя, тег или digest, способ доставки и политику получения образа |
| Контейнер завершается или многократно запускается | Причину завершения, логи приложения, команду запуска и конфигурацию |
| Контейнер работает, но Pod не готов | Путь и порт readiness probe, время инициализации и готовность зависимостей |
| Реплики готовы, но запросы не доходят | Метки и селектор Service, конечные точки и сетевой путь |
| Rollout завершился, но поведение изменилось неправильно | Прикладные тесты, совместимость версий и внешнее состояние |
Для учебного манифеста отдельно проверяют наличие локального образа: запрет загрузки через Never был задан намеренно. Если изменить этот режим на рабочий registry, появятся другие условия, включая доступ и проверку артефакта. Это уже изменение примера, которое нужно понимать.
После исправления причины повторно проверяют состояние и приложение. Если выбран откат, сохраняют сведения о проблемной ревизии и причинах возврата. Это помогает не повторить тот же выпуск и отделить ошибку конфигурации от дефекта кода.
Как масштабировать число реплик
Масштабирование меняет количество экземпляров, а обновление меняет их шаблон. Увеличение replicas само по себе не создает новую ревизию. Если одновременно работает механизм автомасштабирования, нужно определить, кто управляет этим полем, чтобы разные источники конфигурации не перезаписывали решения друг друга.
Дополнительные реплики полезны только при подходящей архитектуре приложения и достаточных ресурсах. Локальные сессии, эксклюзивная блокировка файла или неподготовленная общая БД могут ограничивать такой способ роста. Deployment поддерживает количество Pod, но не доказывает линейное увеличение производительности.
Выбирая площадку, можно рассматривать Kubernetes в облаке. Версию платформы, порядок ее обновления, границы администрирования и доступную емкость уточняют для конкретной услуги. Из общего описания Deployment нельзя вывести эти условия для любого провайдера.
Когда Deployment не подходит
Если приложению нужны устойчивые идентификаторы экземпляров, определенная связь с постоянным хранилищем или особый порядок запуска, стоит рассмотреть StatefulSet и требования самого приложения. Для задания до завершения есть Job, для периодического запуска — CronJob, для размещения экземпляров на подходящих узлах — DaemonSet.
Deployment может запускать сервис с внешней БД, однако он не превращает локальные данные Pod в надежное распределенное хранилище. Заменяемость экземпляра и сохранность состояния нужно проверять отдельно. При выборе уровня размещения полезно понимать, чем отличаются контейнеры и виртуальные машины.
Что проверить перед изменением
Перед обновлением команда должна знать целевой контекст и пространство имен, состав изменений, доступность артефакта, запас ресурсов и критерии успеха. Отдельно проверяют совместимость старой и новой версий, готовность приложения, завершение запросов и возможный возврат внешней конфигурации и данных.
После изменения проверяют не только счетчики реплик, но и прикладной результат. Если новая версия не подходит, принимают решение об исправлении или откате, сохраняют причину и синхронизируют рабочую конфигурацию. Организацию такого процесса можно обсуждать через сервисы DevOps, не сводя его к одной команде.
Deployment полезен тем, что делает управление набором экземпляров декларативным и наблюдаемым. Чтобы это помогало выпускать изменения предсказуемо, нужны согласованный манифест, понятные проверки и честные границы отката. Именно они превращают успешный запуск Pod в проверенное изменение приложения.