RAG: как LLM отвечает по корпоративным документам
Как RAG находит сведения в документах компании и передает их LLM. Разбираем архитектуру, подготовку данных, права доступа и проверку качества ответов.
Статья
Время на прочтение: 18 минут
Как RAG находит сведения в документах компании и передает их LLM. Разбираем архитектуру, подготовку данных, права доступа и проверку качества ответов.
Разобраться, что такое RAG, проще на рабочем примере. Сотрудник спрашивает у помощника, как согласовать установку новой программы. Чтобы ответить по правилам компании, помощнику нужны действующий регламент и инструкция для его подразделения. RAG помогает найти эти документы и передать подходящие выдержки языковой модели. Та формулирует ответ по найденным сведениям, а приложение показывает ссылки на источники. Ниже — условный пример, а не описание внедрения Nubes.
RAG расшифровывается как Retrieval Augmented Generation — генерация с дополнением найденной информацией. В таком приложении искусственного интеллекта (ИИ) LLM (Large Language Model), или большая языковая модель, отвечает за создание текста. Поисковая часть предоставляет ей контекст: фрагменты документов, которые относятся к вопросу и доступны пользователю. Рассмотрим, как устроена эта связка, что подготовить для ее запуска и как проверить результат.
Языковая модель умеет объяснять, обобщать и сопоставлять сведения. RAG-система добавляет к генерации поиск по выбранным источникам. Перед ответом она извлекает сведения из базы знаний и включает их в запрос к LLM. Для этого обычно не требуется заново обучать модель при каждом изменении документа: обновляется поисковое представление источников. Однако новая версия файла попадет в ответы только после того, как ее обработает контур обновления.
Такой подход полезен, когда нужно отвечать по ограниченному корпусу: инструкциям, технической документации, внутренним справочникам. Пользователь задает вопрос привычным языком, а система помогает собрать сведения из нескольких мест. В отличие от обычной выдачи ссылок, она может сразу объяснить порядок действий. Цена этого удобства — необходимость проверять не только поиск, но и формулировку ответа.
Найденные документы не делают генерацию безошибочной и не исключают галлюцинации ИИ. Модель способна неверно связать факты, пропустить условие или сослаться на неподходящую выдержку. Поэтому RAG — способ дать LLM нужный материал и сделать ответ проверяемым, а не гарантия его истинности.
У RAG есть два связанных процесса. Первый готовит документы к поиску и обновляет индекс. Второй выполняется, когда приходит вопрос. Разделять их полезно и при проектировании: ошибки подготовки источников нельзя исправить одной только настройкой генерации.
Сначала приложение получает документы из разрешенных источников: например, файлового хранилища или системы управления знаниями. Из них извлекают текст, сохраняют структуру и метаданные, отделяют полезное содержимое от повторяющихся меню и служебных блоков. Затем материал разбивают на фрагменты и создают представления, по которым будет работать поиск. Этот процесс подготовки и загрузки поискового представления называют индексацией.
Вместе с содержимым нужны сведения о происхождении: ссылка, идентификатор документа, версия, раздел, дата обработки и ограничения доступа. Без них трудно показать источник пользователю, заменить устаревшую редакцию или удалить все производные фрагменты. Подготовка завершается загрузкой в индекс и проверкой, что нужные документы действительно находятся.
Вернемся к вопросу об установке программы. Приложение определяет пользователя и область доступных ему сведений, затем ищет подходящие фрагменты. Например, один описывает согласование заявки, другой — ограничения для отдельных категорий ПО. Перед включением в контекст проверяется, что сотрудник вправе видеть оба источника.
Далее найденные выдержки передаются LLM вместе с вопросом и правилами ответа. Модель должна объяснить порядок согласования, сохранить существенные условия и указать источники. Приложение связывает ссылки с конкретными документами или разделами. Сам факт наличия ссылки еще не доказывает, что она подтверждает каждое предложение: это отдельный предмет проверки.
Если в документах нет нужного условия или две версии противоречат друг другу, полезнее сообщить об ограничении и предложить уточнение, чем достроить правило по общим знаниям. Такой помощник не должен самостоятельно устанавливать программу или менять права сотрудника: поиск сведений и выполнение действий — разные возможности приложения.
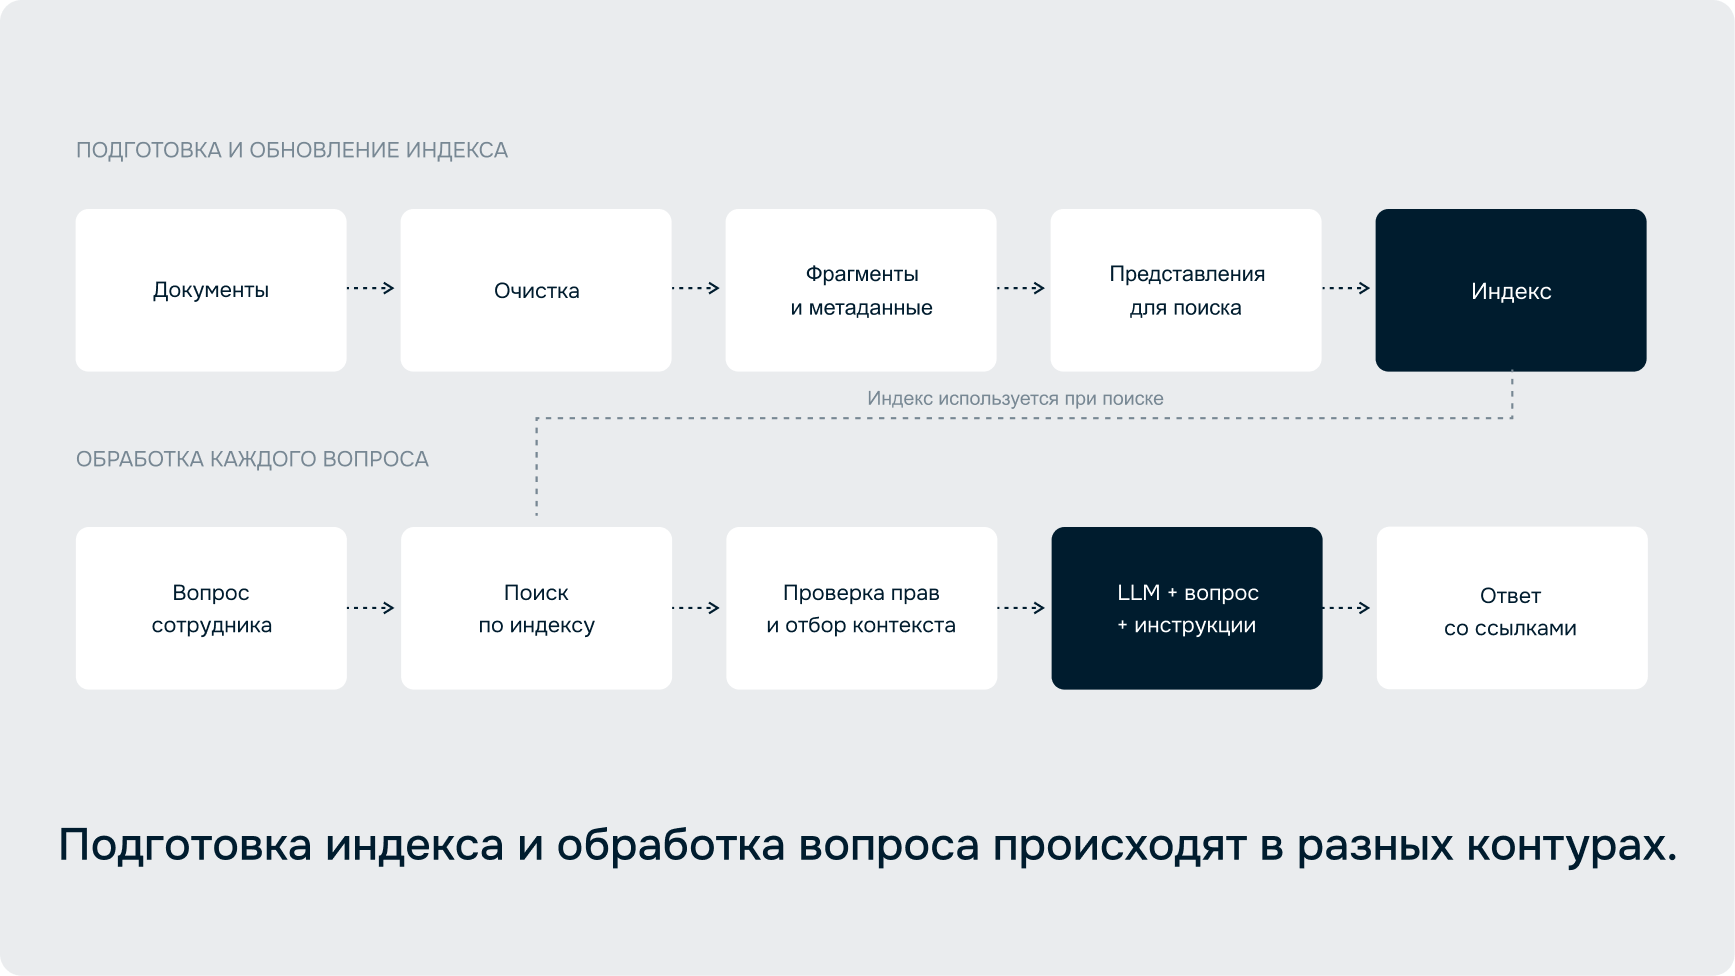
Базовая архитектура включает источники, обработку документов, поисковый индекс, механизм извлечения контекста, языковую модель и приложение, которое связывает эти части. Отдельно нужны средства обновления, контроля доступа и наблюдения за качеством. Одну роль могут выполнять разные сервисы, а несколько ролей — один продукт.
Для первого сценария лучше выбрать ограниченную, понятную базу знаний с назначенным владельцем. Если инструкции противоречат друг другу и никто не определяет действующую редакцию, RAG перенесет эту неопределенность в ответы. Качество исходных данных остается ответственностью компании, даже когда поиск и генерацию выполняет облачный сервис.
Метаданные помогают различать документы, которые похожи по содержанию, но относятся к разным подразделениям, продуктам или периодам. Например, ответ по прошлогоднему регламенту может быть правдоподобным и при этом бесполезным. Поэтому принадлежность источника к нужному процессу нередко важнее его смыслового сходства с вопросом.
Чанк — фрагмент документа, который система рассматривает как единицу поиска и передачи в контекст. Разбиение нужно, чтобы не отправлять модели целую библиотеку ради одного вопроса. Хороший чанк сохраняет законченную мысль и связь с разделом. Слишком маленький может потерять исключение из правила, слишком большой — добавить лишний текст и занять контекстное окно.
Эмбеддинг представляет текст набором чисел — вектором. Он позволяет искать близкие по смыслу фрагменты, даже когда вопрос сформулирован другими словами. Но эмбеддинг не является шифрованием или анонимизацией: производные представления также требуют защиты. Их нельзя автоматически считать безопасными для передачи за пределы выбранного контура.
Поисковый индекс хранит представления документов и обеспечивает извлечение кандидатов. Для векторного поиска используют векторную базу данных либо поисковую платформу с соответствующей возможностью. Отдельная специализированная база данных не обязательна в любой архитектуре: выбор зависит от уже используемых решений, фильтрации, масштаба и результатов тестов.
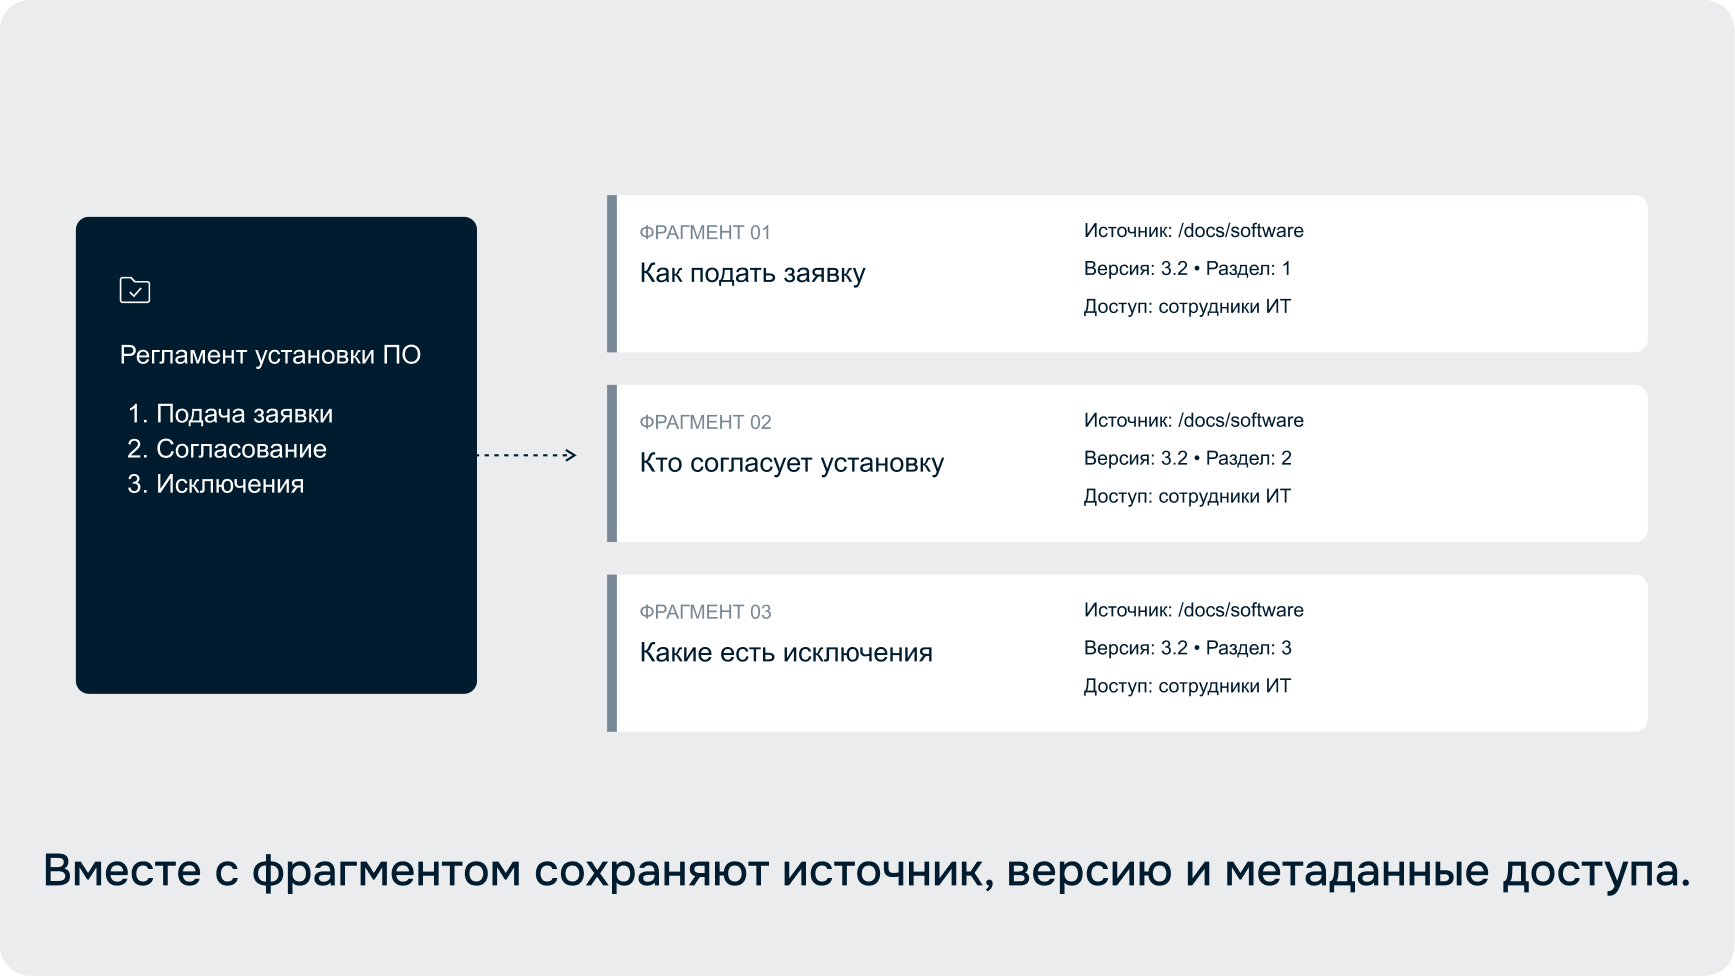
LLM получает не весь индекс, а отобранный контекст. Приложение задает формат ответа, правила ссылок и поведение при недостатке сведений. Полезно явно отделять инструкции приложения от цитируемых документов: текст источника не должен становиться командой для модели.
Объем контекстного окна ограничен. Даже если модель принимает длинный запрос, больше текста не всегда означает лучшее качество: релевантные условия могут затеряться среди похожих фрагментов. Нужно проверять состав, порядок и достаточность контекста, а не только его длину. Выбор LLM оценивают вместе с поиском на задачах компании.
Поиск в RAG отвечает на практический вопрос: какие сведения стоит передать модели для конкретного ответа. Здесь важно не просто найти похожий текст, а сохранить условия, от которых зависит решение. Два распространенных подхода — лексический и векторный поиск; их можно сочетать.
Лексический поиск сопоставляет слова и другие признаки запроса с документами. Он полезен для точных названий, идентификаторов, артикулов и кодов ошибок. Один из распространенных способов ранжирования — BM25. Если сотрудник называет номер регламента, точное совпадение может оказаться полезнее общего смыслового сходства.
Векторный поиск использует эмбеддинги запроса и фрагментов. Он помогает, когда человек пишет «как получить доступ к программе», а инструкция озаглавлена «Порядок оформления заявки на программное обеспечение». При этом близость векторов сама по себе не означает, что найденный документ содержит ответ или относится к нужному подразделению.
Гибридный поиск объединяет результаты или сигналы разных поисковых подходов. Он позволяет учитывать и точные обозначения, и смысловую близость. Подходящий способ объединения выбирают по контрольным вопросам: универсального преимущества для любого корпуса обещать нельзя.
Переранжирование, или reranking, — следующий возможный этап. Отдельный механизм повторно оценивает уже найденных кандидатов и меняет их порядок с учетом запроса. Его задача отличается от объединения поисковых результатов. Если нужный документ вообще не попал в первичный набор, переранжирование не сможет вернуть его из отсутствующего списка.
Поэтому при плохом ответе сначала выясняют, был ли найден нужный источник. Если его нет, проверяют индекс, фильтры, разбиение и поиск. Если он есть, но уступил нерелевантным фрагментам, исследуют ранжирование и отбор контекста. Такой разбор точнее, чем замена модели без понимания причины ошибки.
RAG-система работает с тем представлением документов, которое попало в индекс. Само по себе сохранение нового файла не гарантирует, что следующий ответ будет построен по нему. Между источником и поиском есть обработка, а у нее — расписание, ошибки и правила повторного запуска.
Для сканов требуется распознавание текста — OCR. Нужно проверить не только читаемость отдельных слов, но и сохранение значимых связей: заголовков, пунктов, колонок и примечаний. В таблице условие часто определяется одновременно строкой и столбцом. Если извлечь ее как случайную последовательность ячеек, модель может получить правильные числа с неправильным смыслом.
Повторяющиеся шапки, подписи и копии одного регламента создают лишние кандидаты. Их стоит отделять от полезного содержимого, сохраняя ссылки на оригиналы. Разбиение по структуре документа обычно требует проверки на реальных вопросах: один и тот же размер чанка не обязан подходить короткой инструкции и большому техническому руководству.
Исходные файлы можно хранить отдельно от поисковых представлений. Для этой роли подходит, например, объектное хранилище S3. Но хранилище не выполняет автоматически всю подготовку RAG: извлечение текста, индексирование и проверку актуальности необходимо организовать отдельно.
В процессе обновления нужно уметь обнаружить изменение, обработать новую версию и заменить связанные фрагменты. По идентификатору документа должно быть понятно, какие записи ему принадлежат. Иначе в индексе могут остаться сразу действующая и устаревшая инструкции, а поиск будет выбирать между ними по сходству с вопросом.
Удаление касается не только исходного файла. Следует определить, как очищаются индекс, производные представления и кэши, где могли сохраниться выдержки или готовые ответы. Смена прав также должна отражаться в выдаче: документ, доступный вчера, сегодня может быть закрыт для пользователя. Ждать очередной полной переиндексации допустимо не для любого требования доступа.
Полезно наблюдать за задержкой обновления и ошибками обработки. Для читателя важна не дата файла сама по себе, а возможность понять, на какую редакцию опирается ответ. Если актуальность нельзя подтвердить, приложение должно обозначить ограничение, а владелец базы знаний — иметь способ исправить источник.
Поисковый помощник может собрать корпоративные данные, которые раньше были распределены по разным системам. Это повышает удобство, но требует внимательно проверить границы доступа. Безопасность RAG не обеспечивается только тем, что документы размещены в закрытом хранилище или модель работает локально.
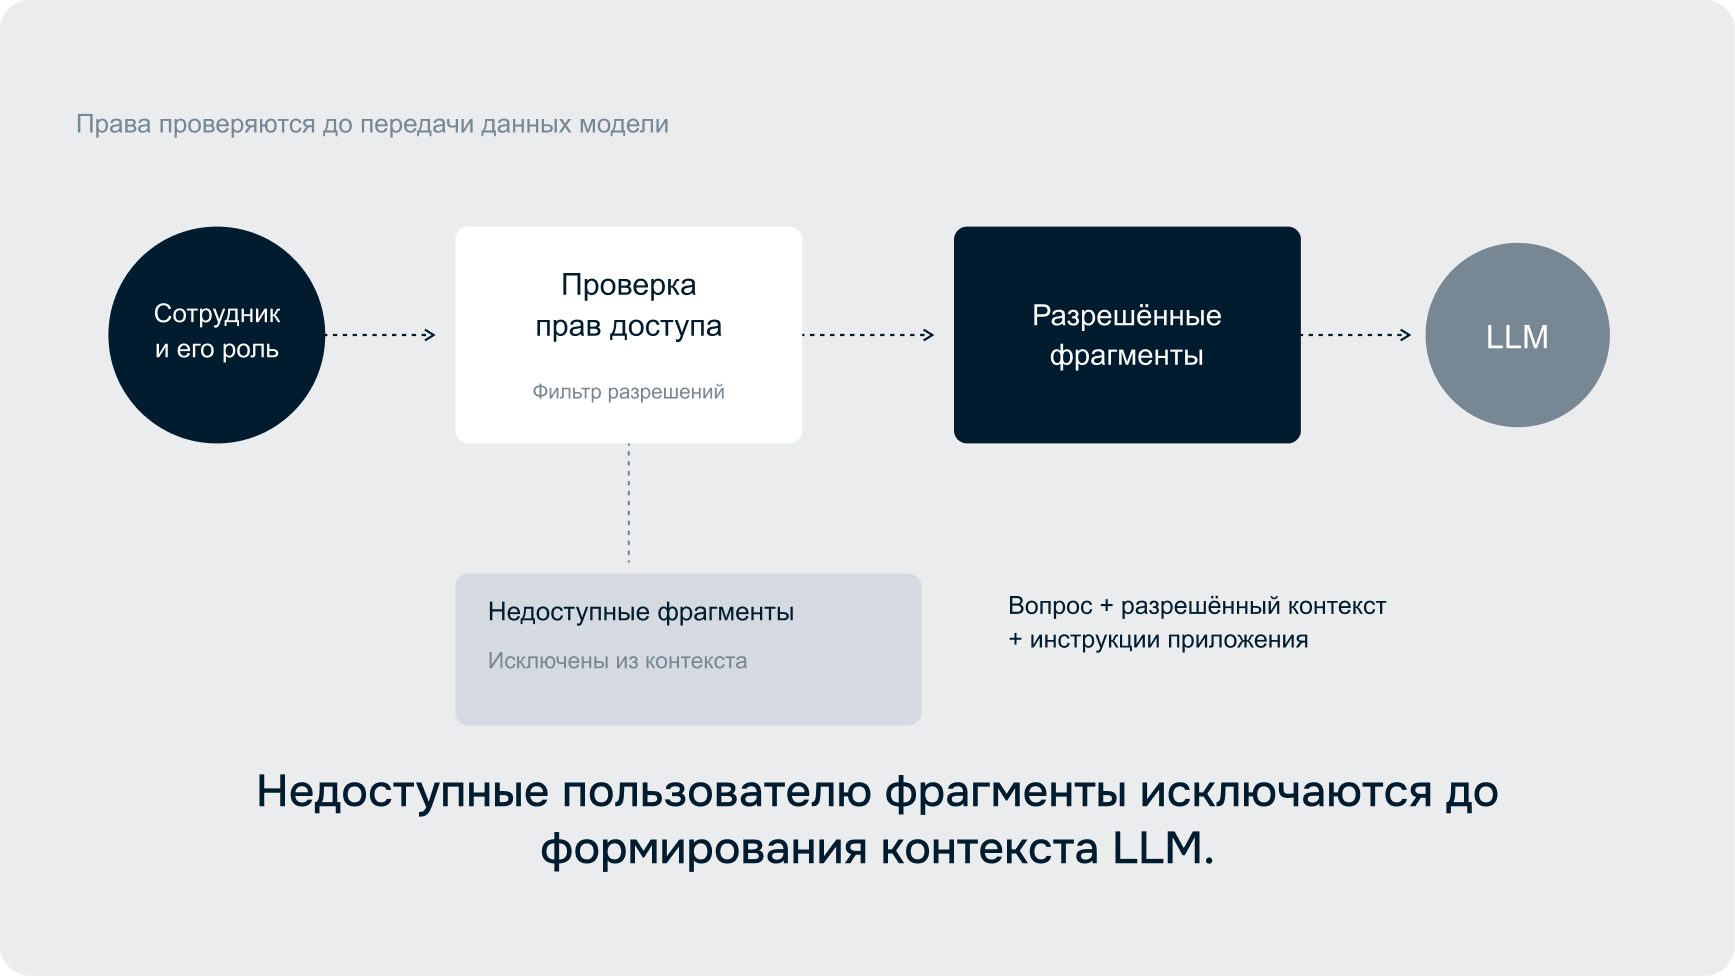
Права доступа необходимо учитывать до включения найденных фрагментов в контекст LLM. Приложение должно знать, от чьего имени выполняется поиск, к какой организации и роли относится пользователь, какие источники ему разрешены. Если закрытый документ уже передан модели, просьба «не раскрывать секреты» не заменяет контроль доступа.
Нужны проверки на разных ролях: обычный сотрудник, руководитель, участник другого подразделения. В многопользовательской среде важно исключить смешение данных организаций. Фильтрация должна сохраняться при объединении поиска, переранжировании и работе с кэшем. Это требование к целой цепочке, а не настройка только последнего экрана ответа.
В документе могут оказаться команды, адресованные модели: например, просьба игнорировать правила приложения или передать сведения по внешней ссылке. Такие попытки называют prompt injection. Даже если источник входит в корпоративную базу знаний, его содержимое следует рассматривать как данные, а не как доверенную инструкцию для LLM.
Защита включает разделение инструкций и контекста, ограничение инструментов и внешних действий, проверку загрузки документов и тесты на утечки. Отдельно определяют, какие вопросы, фрагменты и ответы сохраняются в логах, кто их читает и как долго они хранятся. Диагностический журнал не должен становиться неучтенной копией закрытых документов.
При выборе внешних сервисов нужно проверить условия обработки и хранения данных, место размещения компонентов и доступ операторов. Корпоративные данные не должны попадать во внешнюю модель без проверки принятой политики. Локальная модель дает иной уровень управления инфраструктурой, но не устраняет ошибки прав, небезопасные логи или вредоносные инструкции в контексте. Эти риски подробно рассматривает OWASP в рекомендациях по безопасности RAG.
Начать стоит с задачи пользователя. Если ему нужно найти и открыть действующий документ, обычный поиск может быть достаточным. Генерация полезна, когда требуется объяснить порядок действий, сопоставить несколько источников или сформулировать краткий ответ. За это придется добавить проверку того, насколько ответ соответствует документам.
| Подход | Основная задача | Что меняется при обновлении знаний | Источники и проверяемость |
|---|---|---|---|
| Поиск | Найти документы и показать релевантные результаты | Источники и поисковый индекс | Пользователь открывает оригинал и проверяет его сам |
| RAG | Найти сведения и сформулировать по ним ответ | Источники, индекс и контекст запроса; веса модели обычно не меняются | Ссылки можно связать с найденными выдержками; соответствие ответа им нужно проверять |
| Fine-tuning | Адаптировать поведение модели на примерах | Данные дообучения и параметры модели в выбранном процессе | Само дообучение не обеспечивает ссылки на актуальные оригиналы |
Обычный поиск не адаптирует поведение генератора. В RAG инструкции и найденный контекст направляют текущий ответ без обучения весов. Дообучение может помочь с форматом, стилем или специализированным поведением, но его не следует автоматически считать способом поддерживать текущую редакцию всех регламентов. RAG и fine-tuning можно сочетать: один подход предоставляет внешние знания, другой адаптирует поведение. AWS сравнивает эти подходы с учетом целей и требований к данным. Выбор проверяют на своей задаче, а не по названию технологии.
RAG также не равен ИИ-агенту. Агент может выбирать инструменты и выполнять последовательность действий в пределах выданных полномочий. Поиск по базе знаний бывает одним из его инструментов, но сам по себе не делает помощника агентом. Для ответа по регламенту агентная архитектура не обязательна.
Первый сценарий — помощь сотрудникам по внутренним инструкциям. Вопросы о согласованиях, доступных сервисах или порядке оформления заявок часто требуют сведений из нескольких разделов. Здесь важны понятные ссылки, актуальность и возможность уточнить, к какому подразделению относится правило.
Второй — поддержка по технической документации. Помощник может объяснить различия версий продукта или собрать порядок проверки ошибки. Если инструкции зависят от модели оборудования, конфигурации или версии ПО, эти признаки должны участвовать в поиске. Ответ по соседней версии может выглядеть убедительно и при этом привести к неверным действиям.
Третий — работа специалистов с большой базой регламентов. RAG помогает найти и сопоставить положения, но не снимает необходимость экспертной оценки, особенно когда документы неполны или противоречивы. Уместность помощника определяется качеством доступных источников и допустимой ценой ошибки. Автоматическое выполнение действий требует отдельного проектирования и полномочий.
Пилот лучше строить вокруг одного понятного сценария. Формулировка «загрузить все документы и сделать чат» не задает критериев успеха. Полезнее определить, кому нужен ответ, какие источники считаются достоверными, какие ограничения обязательны и кто принимает результат.
Для начала назначают владельца процесса и владельца базы знаний, выбирают ограниченный корпус и проверяют права на его использование. Затем собирают вопросы из реальной работы, ожидаемые источники и существенные условия ответа. В наборе должны быть не только простые вопросы, которые хорошо совпадают с заголовками документов.
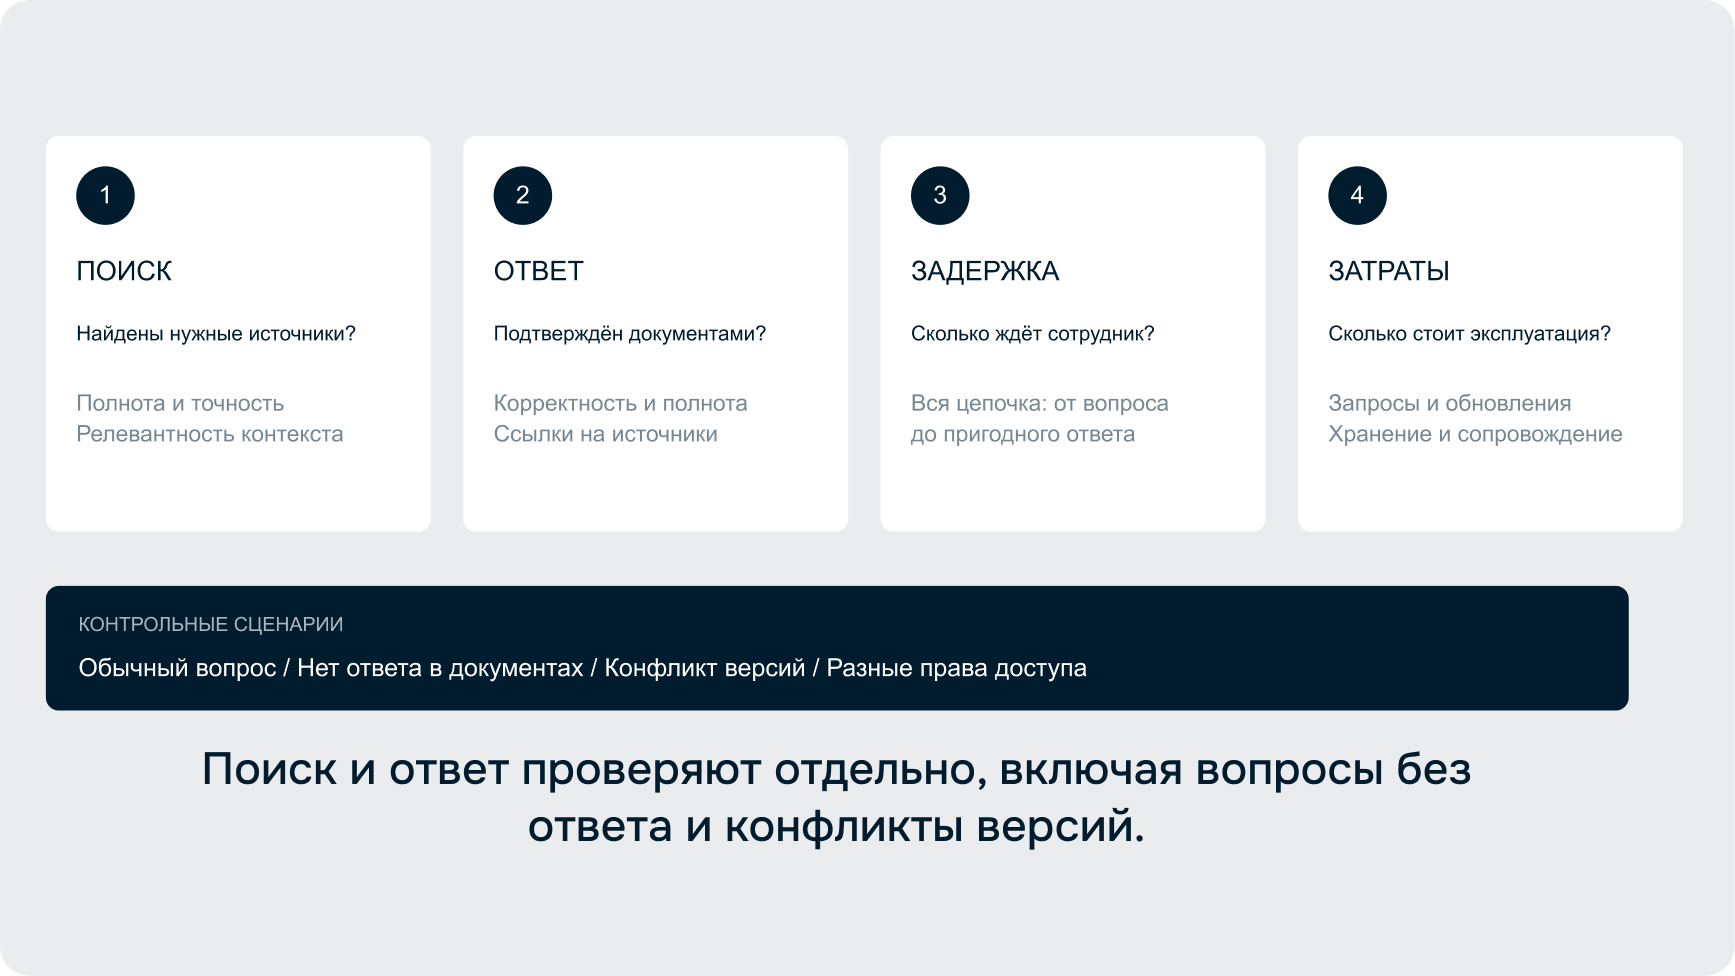
Нужны примеры с несколькими источниками, неоднозначной формулировкой, отсутствующим ответом, конфликтом версий и ограничением по роли. Для запроса без достаточных сведений корректным результатом может быть отказ от вывода или уточнение. Без таких случаев система будет выглядеть точной только на удобных для нее вопросах.
Критерии согласуют до запуска: что считается полезным ответом, какие ошибки недопустимы, какую задержку выдерживает сценарий. Универсальный процент качества здесь мало помогает. Пилот завершается разбором ошибок и решением, какие изменения нужны в документах, поиске, модели и эксплуатации.
Часть компонентов можно использовать как управляемые сервисы, часть — разворачивать самостоятельно. Для приложения, обработки документов и поискового слоя может понадобиться облачный сервер. Конкретные ресурсы определяют по объему корпуса, интенсивности запросов и замерам выбранного стека. Количество файлов само по себе не задает размер инфраструктуры.
Если компания запускает модель у себя, одним из вариантов вычислительной площадки становится облачный сервер с GPU. Потребность в GPU зависит от модели, способа инференса и нагрузки. При использовании внешнего API организация может вовсе не размещать собственный ускоритель; RAG как подход этого не требует.
Чтобы оценить такой вариант размещения, полезно отдельно разобраться, что такое облако с GPU. Затем сравнить требования к данным, доступную экспертизу и эксплуатационные затраты. Наличие вычислительных ресурсов не заменяет подготовку документов, поисковый слой и контроль качества ответов.
В любом варианте нужно назначить ответственных за обновление базы знаний, ошибки обработки, мониторинг, изменения модели и проверку доступа. Иначе после успешной демонстрации помощник постепенно начнет отвечать по устаревшим сведениям, а причины ухудшения останутся незаметными.
Проверка RAG должна показывать, где появилась ошибка: при подготовке документов, поиске, отборе контекста или генерации. Отдельная оценка этих этапов помогает менять нужный компонент и сравнивать версии системы. Такой подход описан в руководстве Microsoft по проектированию и оценке RAG.
Для контрольного вопроса размечают документы или фрагменты, которые действительно нужны для ответа. Затем смотрят, попали ли они в кандидаты и в итоговый контекст. Полнота показывает, какая доля необходимых сведений найдена; точность — насколько найденный набор свободен от нерелевантного материала. Эти показатели следует определять для конкретного тестового набора и этапа поиска.
Если нужный источник не найден, проверяют, обработан ли файл, сохранились ли значимые таблицы, подходит ли разбиение на чанки и не отсекает ли документ ошибочный фильтр. Отдельно проверяют вопросы с точными обозначениями и перефразированными формулировками. Это позволяет понять, когда помогает гибридный поиск, а когда проблема находится в исходных данных.
У ответа проверяют полезность, полноту, корректность ссылок и соответствие предоставленному контексту. Последнее часто называют faithfulness — обоснованностью ответа найденными сведениями. Но даже точный пересказ устаревшего регламента не делает его актуальным. Соответствие источнику и истинность самого источника — разные вопросы.
Автоматические оценки полезны для сравнения версий, однако их стоит сверять с экспертной разметкой. В тестах должны сохраняться роли пользователей и условия доступа. Отдельно фиксируют случаи, когда модель уверенно ответила при отсутствии нужных данных, выбрала неправильную редакцию или пропустила важное исключение.
Затраты возникают и при подготовке базы знаний, и при обработке вопросов. В первой части учитывают извлечение текста, OCR, создание эмбеддингов, хранение и обновление индекса. Во второй — поиск, переранжирование, объем переданного контекста, генерацию и работу приложения. Для собственного размещения добавляются ресурсы и сопровождение, для внешнего сервиса — его фактические условия тарификации.
Измерять нужно всю цепочку, которую видит сотрудник: от отправки вопроса до получения пригодного ответа. Уменьшение задержки одного компонента не обязательно ускорит приложение в целом. Аналогично низкая цена отдельного запроса не описывает стоимость эксплуатации с обновлениями, проверками и поддержкой. Обещать экономию до таких замеров преждевременно.
RAG не исправляет исходные документы и не определяет автоматически, какое из противоречащих правил действует в компании. Он зависит от полноты корпуса, качества извлечения, актуальности индекса и корректности прав доступа. Сложные таблицы, неявные связи между документами и вопросы без готового ответа потребуют отдельной проверки.
Галлюцинации также остаются возможными: модель может ошибиться даже при полезном контексте. Ссылки, правила отказа и тестирование помогают обнаруживать и уменьшать такие ошибки, но не дают абсолютной гарантии. Для значимых решений нужен понятный способ перейти к источнику и, когда требуется, обратиться к ответственному специалисту.
Полезный пилот начинается с ограниченной задачи, управляемой базы знаний и критериев проверки. Если система находит доступные актуальные документы, корректно объясняет их и обозначает недостаток сведений, ее можно развивать дальше. Следующий шаг определяется результатами вопросов сотрудников и разбором ошибок, а не количеством загруженных файлов.
Источники для дальнейшего чтения: Microsoft — проектирование и оценка RAG; AWS — RAG и fine-tuning; OWASP — безопасность RAG.