Zabbix: что это такое и как работает система мониторинга

 
Zabbix: что это за программа и как работает система мониторинга

Разбираем, что такое Zabbix, как устроены сервер, агенты и прокси, какие метрики собирает система и как она обнаруживает проблемы в ИТ-инфраструктуре.

Статья
Время на прочтение: 11 минут

Если коротко объяснить, Zabbix: что это за программа и как работает, ответ будет таким: Zabbix — система мониторинга, которая собирает метрики инфраструктуры, сопоставляет их с правилами и уведомляет команду о проблемах. Она наблюдает за серверами, сетевыми устройствами, приложениями и сервисами, хранит значения, строит диаграммы и подает сигнал, когда показатель выходит за заданный предел.

Коротко: что такое Zabbix и зачем он нужен

Это программная система мониторинга Zabbix с открытым исходным кодом. Она помогает видеть состояние ИТ-инфраструктуры в одном веб-интерфейсе: от CPU, RAM и disk I/O отдельного хоста до доступности сайта, сетевой задержки и выполнения согласованного уровня услуги. По актуальной документации ветка 7.4 является текущей, а продукт распространяется под лицензией AGPL-3.0; коммерческая поддержка доступна отдельно.

Как работает Zabbix на практике: получает данные, сохраняет значения, вычисляет выражение правила и при проблеме фиксирует инцидент. Затем действие выбирает канал, адресата и сценарий эскалации. В результате инженер узнает не просто о «красном» сервере, а о конкретной причине, времени начала и затронутом сервисе.

Какие задачи решает платформа

Система мониторинга Zabbix объединяет технический контроль и оценку качества услуг. Она собирает телеметрию, рассчитывает доступность, помогает искать узкие места и дает факты для capacity planning. При правильной настройке платформа сокращает время обнаружения инцидента и показывает, какие узлы сети требуют внимания раньше остальных.

Мониторинг серверов Zabbix, сетей и приложений

Мониторинг серверов Zabbix охватывает загрузку CPU, RAM, файловые системы, процессы, журналы, uptime и disk I/O. Для коммутаторов и маршрутизаторов используют SNMP, а приложения и аппаратные датчики проверяют специализированными интерфейсами. HTTP agent, ICMP и простые сетевые пробы позволяют контролировать сервисы без установки агента.

Виртуальный сервер можно добавить как обычный узел сети, связать с профилем мониторинга и сразу получать базовые показатели. Дальше набор элементов расширяют с учетом роли машины: веб-сервер, СУБД, шлюз или прикладной сервис.

Доступность, производительность и SLA

Чтобы понять, как работает Zabbix, достаточно проследить одну проверку: платформа измеряет доступность порта, URL или процесса и оценивает производительность. Порог задают в правиле, например высокая загрузка сохраняется дольше пяти минут. Для бизнес-сервиса система рассчитывает SLA и показывает влияние аварии на уровень услуги.

Как устроен Zabbix

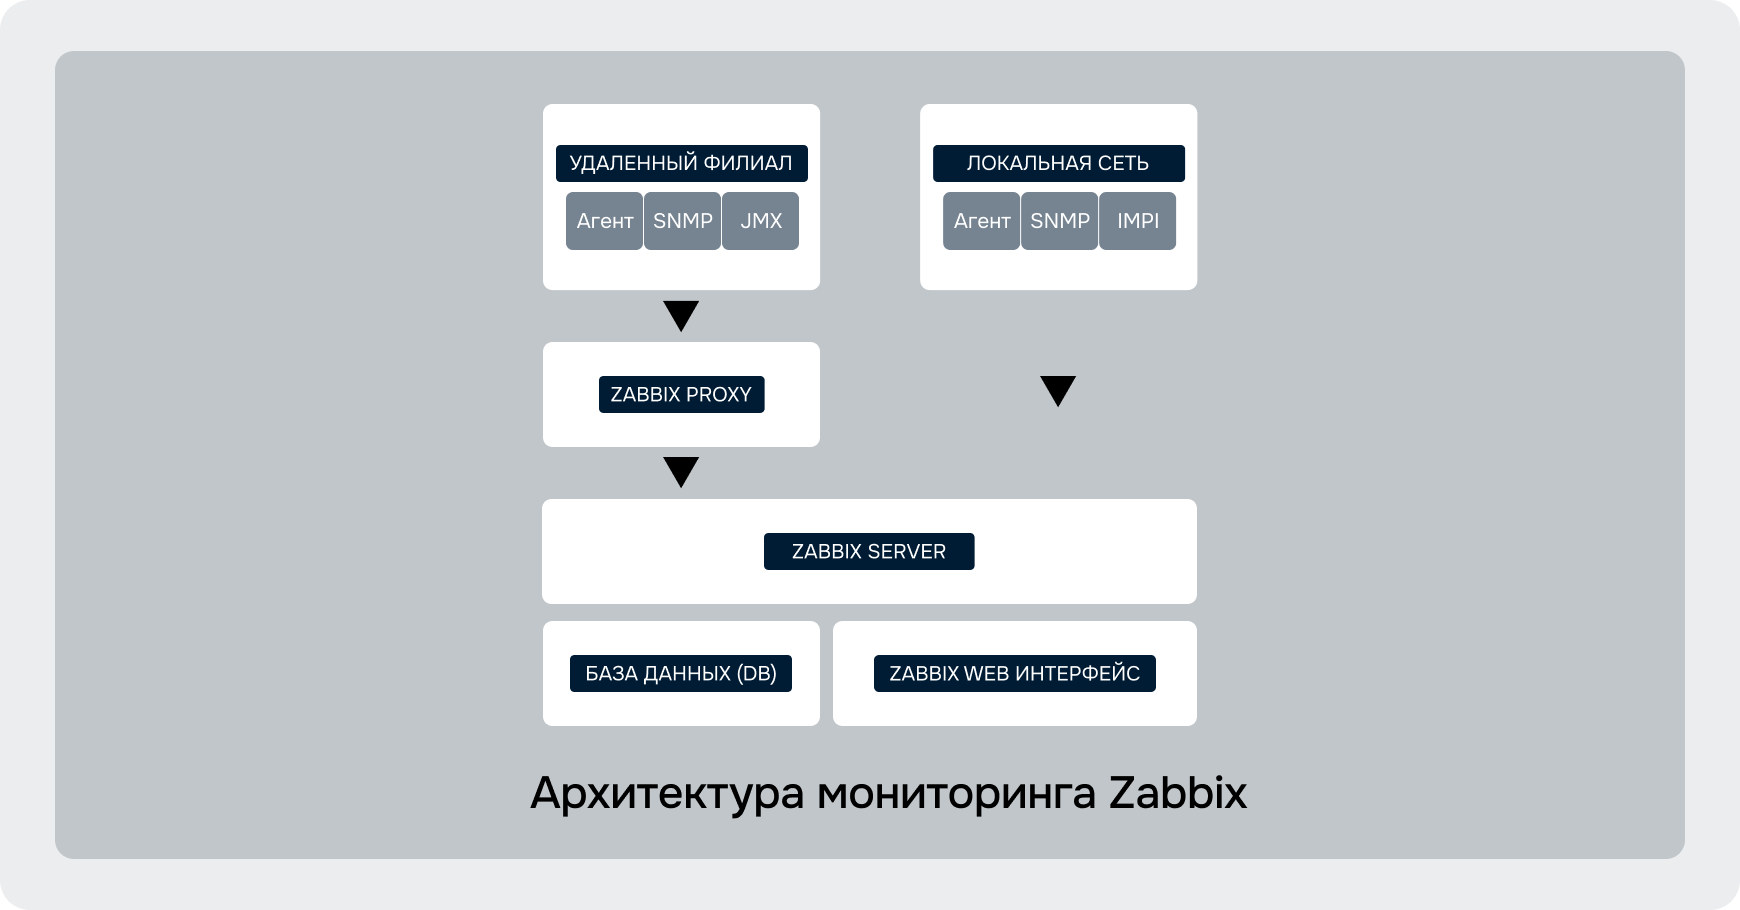
Основная архитектура включает центральный сервер, агенты, прокси, базу данных и веб-интерфейс. Компоненты можно разместить вместе для небольшой среды или разделить при росте нагрузки. В крупных инсталляциях сервер разворачивают в режиме high availability, а сбор распределяют между удаленными сборщиками.

Архитектура мониторинга: центр получает показатели напрямую и через прокси, хранит их в БД и показывает во frontend
Zabbix Server

Zabbix Server — центральный процесс. Он принимает значения от агента и прокси, вычисляет правила, фиксирует проблемы и отправляет уведомления. Сервер также синхронизирует конфигурацию с удаленными сборщиками и обращается к базе данных, поэтому его производительность зависит от числа значений в секунду и тяжести запросов.

Zabbix Agent и Agent 2

Zabbix Agent устанавливают на наблюдаемый сервер или рабочую станцию. Агент читает метрики ОС, файлы журналов и пользовательские параметры. Zabbix Agent 2 — новое поколение с плагинной архитектурой: такой агент удобен для расширений и мониторинга приложений. Выбор агента зависит от платформы, нужных плагинов и принятого стандарта эксплуатации.

Администрирование операционных систем становится предсказуемее, когда агент собирает одинаковый набор показателей на Linux и Windows. Шаблоны помогают применять общие правила, а отклонения видны в одном интерфейсе.

Zabbix Proxy

Zabbix Proxy получает телеметрию от удаленных устройств и передает ее на Zabbix Server. В отличие от агента, прокси полезен в филиале, закрытом сегменте или площадке с нестабильным каналом: он буферизует показатели локально и снижает число прямых соединений с центром. Современная архитектура также допускает группы proxy для балансировки и высокой доступности мониторинга.

База данных и веб-интерфейс

База данных хранит конфигурацию, исходные значения, тренды и алерты. Политика retention и housekeeping определяет, сколько записей останется и как быстро будет расти объем. Через веб-интерфейс администратор создает хост, элемент данных, шаблон, условие, диаграмму и панель; API позволяет автоматизировать те же операции.

Как система собирает телеметрию

Каждый измеряемый показатель представлен элементом данных, или item. Для него задают тип, ключ, интервал, единицы и preprocessing. Он может получать готовое значение, выделять его из JSON, преобразовывать строку или становиться dependent item, который использует результат мастер-элемента.

Активные и пассивные проверки

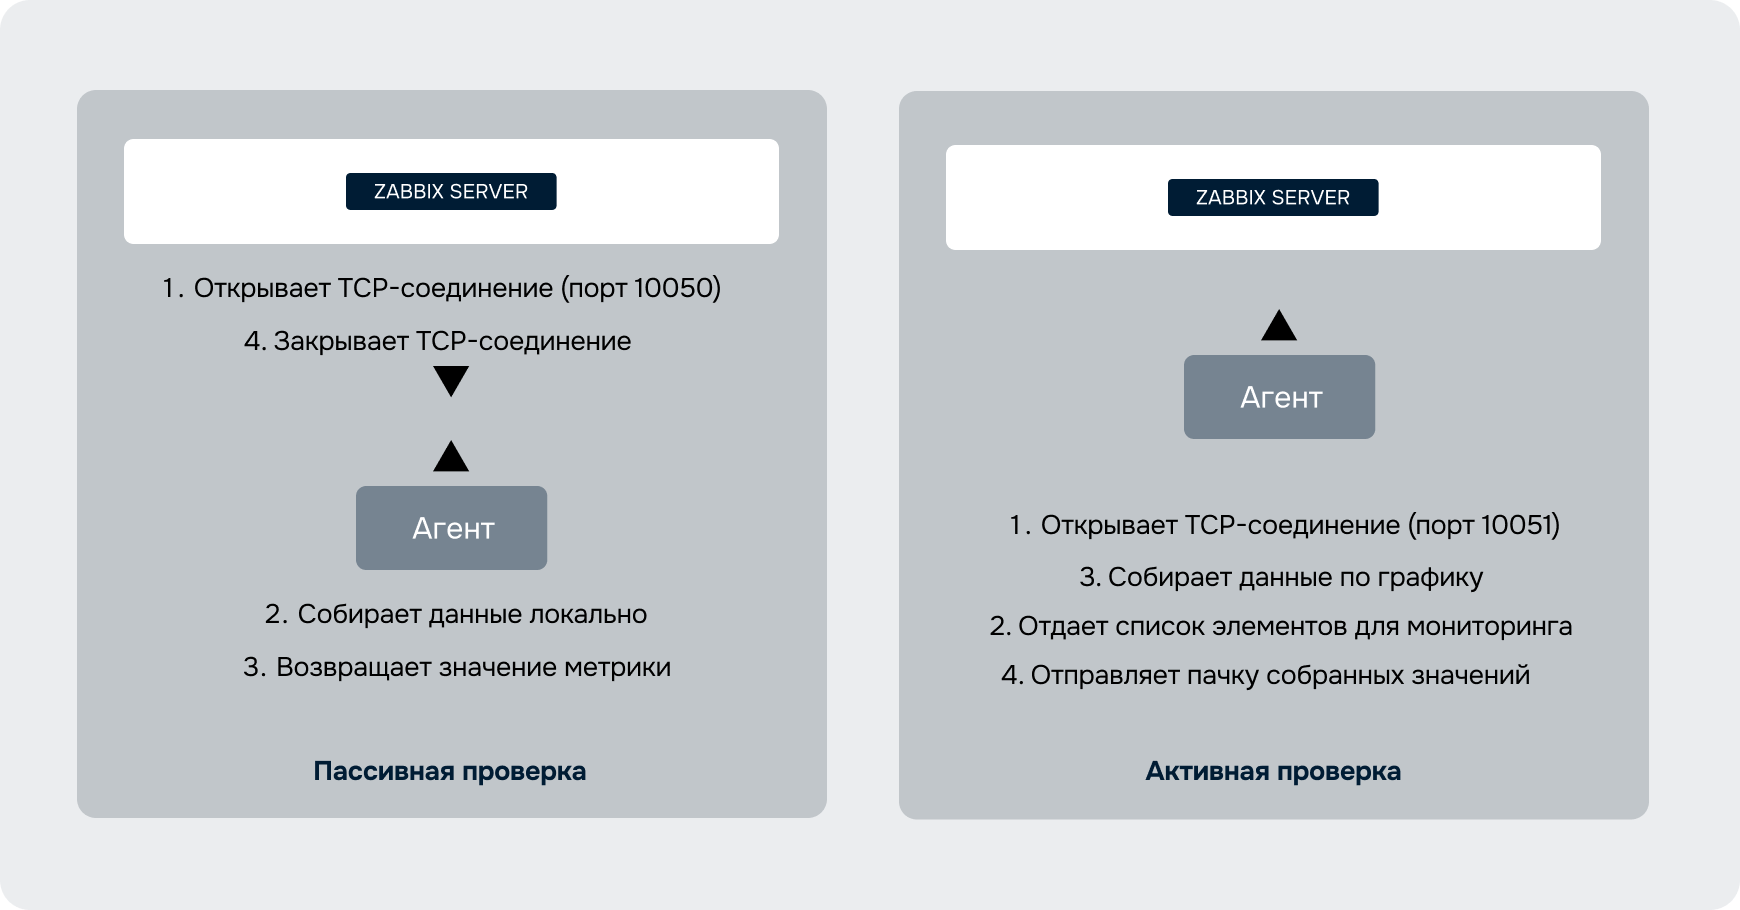
При пассивной проверке Zabbix Server или прокси обращается к агенту и запрашивает конкретное значение. При активной проверке Zabbix Agent сам получает список заданий, собирает показатели и отправляет их получателю. Активная проверка удобна за NAT и при большом количестве агентов; обычный опрос проще для точечного запроса и диагностики.

При passive check платформа инициирует запрос, при active check агент отправляет собранные значения

Без агента: SNMP, IPMI, JMX и simple check

Агент нужен не всегда. SNMP подходит сетевому оборудованию и датчикам, IPMI — аппаратному контроллеру сервера, JMX — Java-приложениям. ICMP сообщает, отвечает ли узел сети, а simple check проверяет доступность сетевого сервиса. Для веб-ресурсов применяют HTTP agent и сценарии мониторинга.

Мониторинг платформы виртуализации дополняет картину телеметрией гипервизора: состоянием ВМ, хранилищ и физических узлов. Это помогает отличить проблему гостевой ОС от нехватки ресурсов на уровне платформы.

Polling и trapping

Polling означает, что система периодически запрашивает значение. Trapping работает наоборот: агент, устройство или приложение отправляет показатель само, например через trapper или SNMP trap. Активная проверка может соседствовать с обоими режимами, чтобы регулярно получать параметры и быстро принимать асинхронный сигнал.

Как значения превращаются в проблемы и оповещения

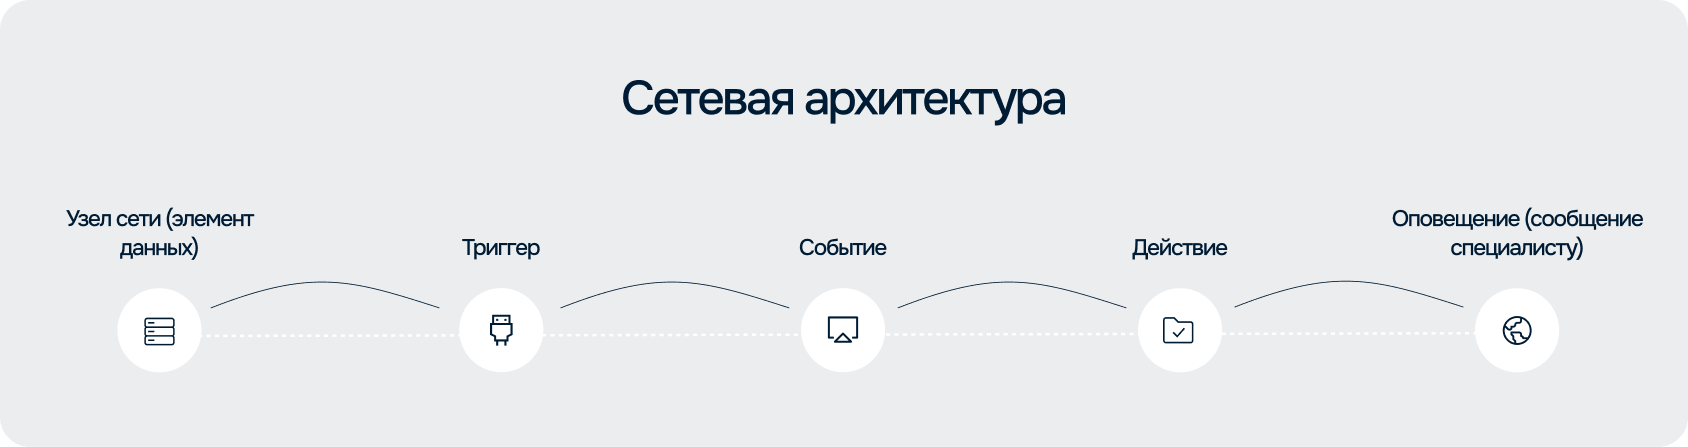
Цепочка выглядит так: узел сети или хост → элемент данных → триггер → событие → действие → оповещение. Такая модель отделяет сбор от реакции. Одну метрику можно использовать в нескольких правилах, а действие настроить с учетом важности, времени и группы ответственных.

Путь от item и trigger до event, action и сообщения инженеру

Узлы сети, элементы данных и шаблоны

Хост описывает наблюдаемый объект и его интерфейсы. Item определяет, какую метрику собирать. Шаблон объединяет элементы данных, условия, диаграммы и правила обнаружения. Его можно связать с группой серверов, поэтому новый узел сети получает стандартный мониторинг без ручного копирования настроек.

Триггеры, события и действия

Триггер — выражение, которое оценивает предыдущие значения и меняет состояние при выполнении условия. Сработавший триггер порождает проблему; корреляция событий и зависимость триггеров уменьшают шум. Действие проверяет параметры проблемы и запускает операции: отправляет уведомление, вызывает webhook или выполняет удаленную команду.

Эскалации и каналы уведомлений

Оповещение можно отправить по email, SMS, через мессенджер, webhook или интеграцию с ITSM. Эскалация меняет адресатов и частоту: сначала уведомление получает дежурный, затем руководитель смены. Для восстановления настраивают отдельное действие, чтобы команда понимала, когда проблема закрылась.

Облачный SIEM решает соседнюю задачу: собирает события безопасности, коррелирует их и помогает расследовать инциденты. Технический мониторинг отвечает за работоспособность сервисов; интеграция двух систем связывает эксплуатационный алерт с контекстом кибербезопасности.

Визуализация и анализ

Веб-интерфейс превращает поток метрик в обзор состояния. Инженер может открыть последние значения, хронологию элемента, график, панель или схему топологии. Представление выбирают под аудиторию: дежурному важны проблемы сейчас, владельцу сервиса — динамика качества, руководителю — сводка по инфраструктуре.

Графики, дашборды и карты сети

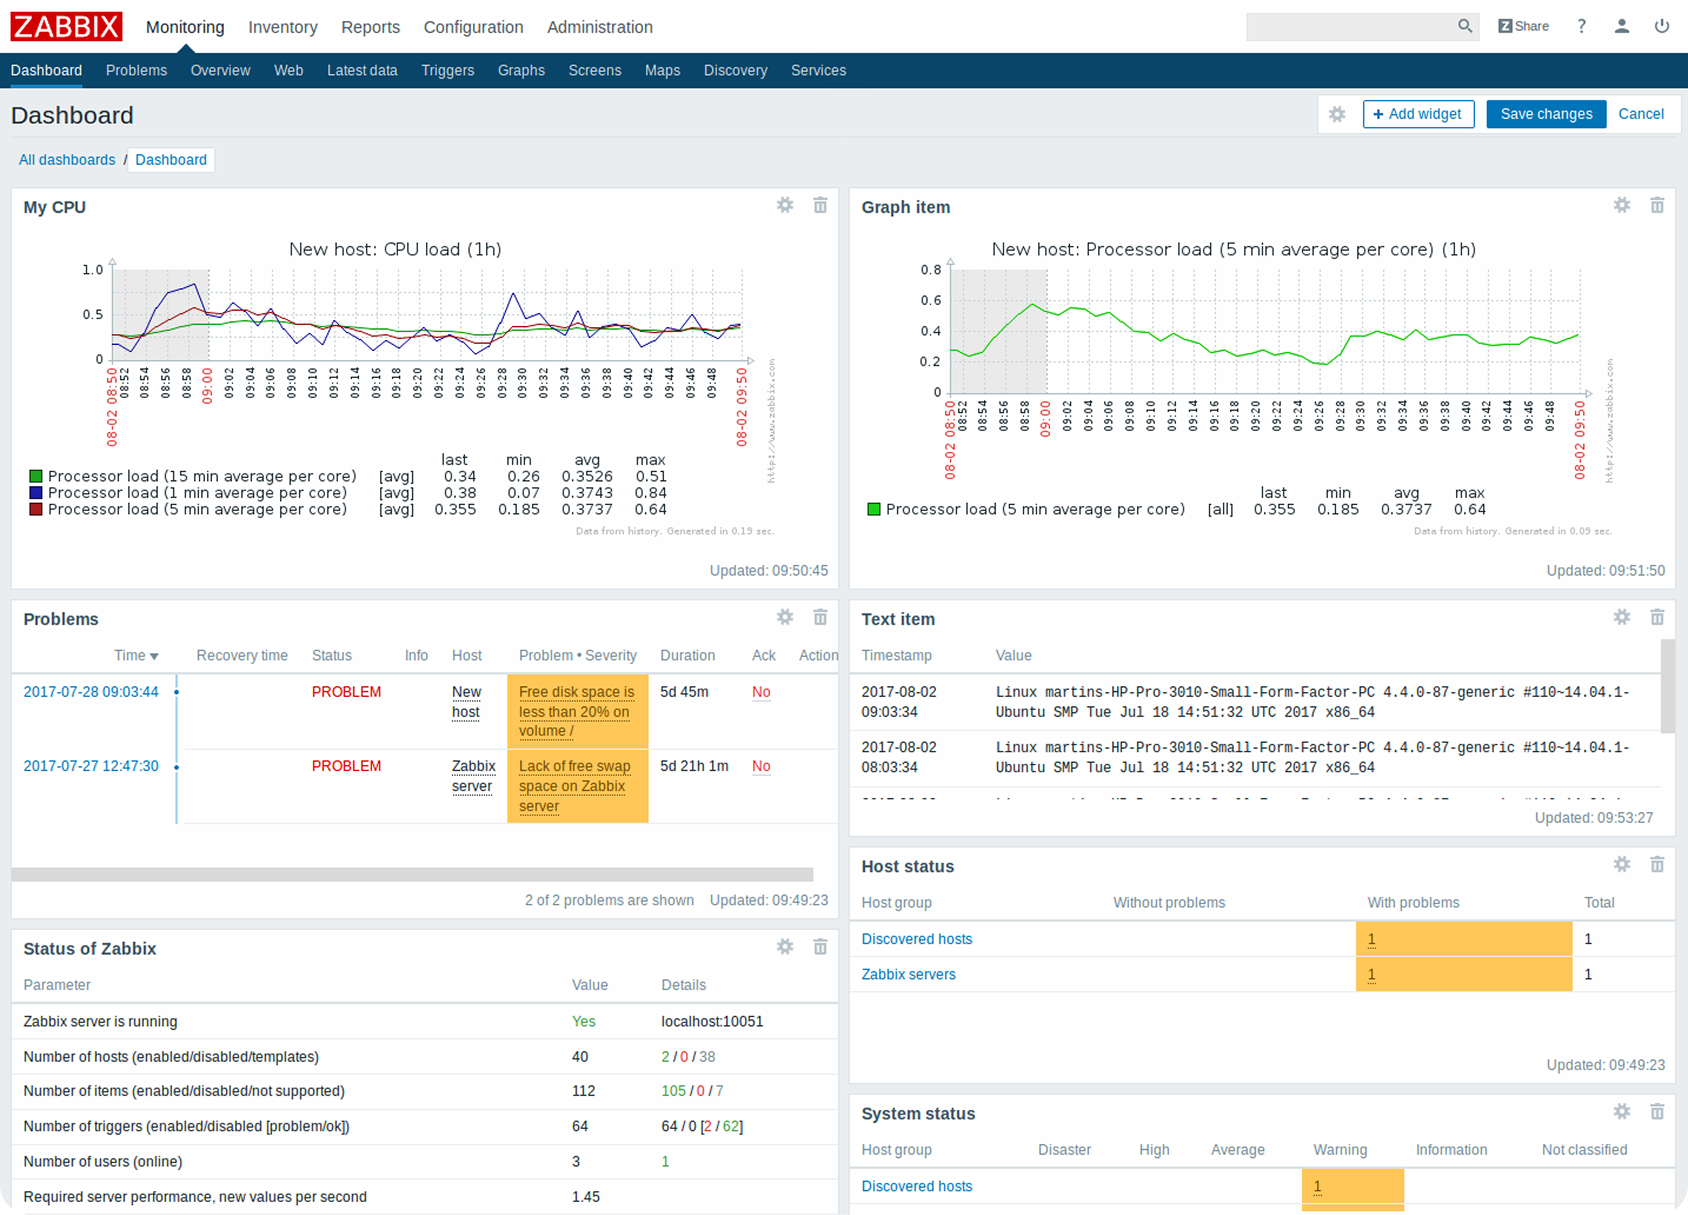
График показывает изменение метрики во времени. Дашборд объединяет виджеты, проблемы, показатели качества и top-N; карта сети отражает связи между площадками и узлами. Хорошая визуализация отвечает на конкретный вопрос, поэтому отдельные панели для NOC и владельца продукта полезнее универсального экрана.

Панель с проблемами, графиками производительности и схемой топологии

История, тренды и прогнозирование

История содержит исходные значения за заданный период. Тренды хранят агрегаты и подходят для долгосрочного анализа с меньшим объемом БД. На их основе платформа прогнозирует, например, когда закончится место на диске. Это полезно для capacity planning, но не заменяет проверку сезонности и изменений нагрузки.

Автоматическое обнаружение и масштабирование

Ручное заведение сотен объектов плохо масштабируется. Платформа поддерживает network discovery, autoregistration активных агентов и low-level discovery. Эти механизмы находят узлы сети, интерфейсы, файловые системы и сервисы, после чего создают объекты по правилам и прототипам.

Network discovery, autoregistration и LLD

Сетевое обнаружение ищет доступные адреса и сервисы. Autoregistration принимает новый активный агент, а правило связывает объект с группой и профилем мониторинга. LLD автоматически создает элементы данных, условия и графики для найденных сущностей. Правило LLD особенно полезно там, где набор дисков или интерфейсов меняется.

Распределенный мониторинг через proxy

Распределенный мониторинг строят через один или несколько Zabbix Proxy. Каждый прокси работает рядом с наблюдаемой площадкой, собирает метрики и отправляет их в центр. Такой распределенный мониторинг уменьшает зависимость от канала и позволяет наращивать инфраструктуру без прямого опроса каждого хоста главным сервером.

Преимущества и ограничения Zabbix

Система мониторинга Zabbix предлагает открытый исходный код, множество типов проверок, шаблоны, обнаружение, API и единую цепочку от показателя до реакции. Решение подходит для серверов, сетей и приложений, а удаленные сборщики помогают обслуживать филиалы.

Ограничения связаны не только с продуктом, но и с проектированием. Большой архив нагружает базу данных; слишком частый опрос увеличивает очередь; небрежные шаблоны создают тысячи лишних элементов. Для крупной среды нужны расчет производительности, housekeeping, контроль очереди, HA и дисциплина изменений.

Сравнение с Prometheus и Grafana

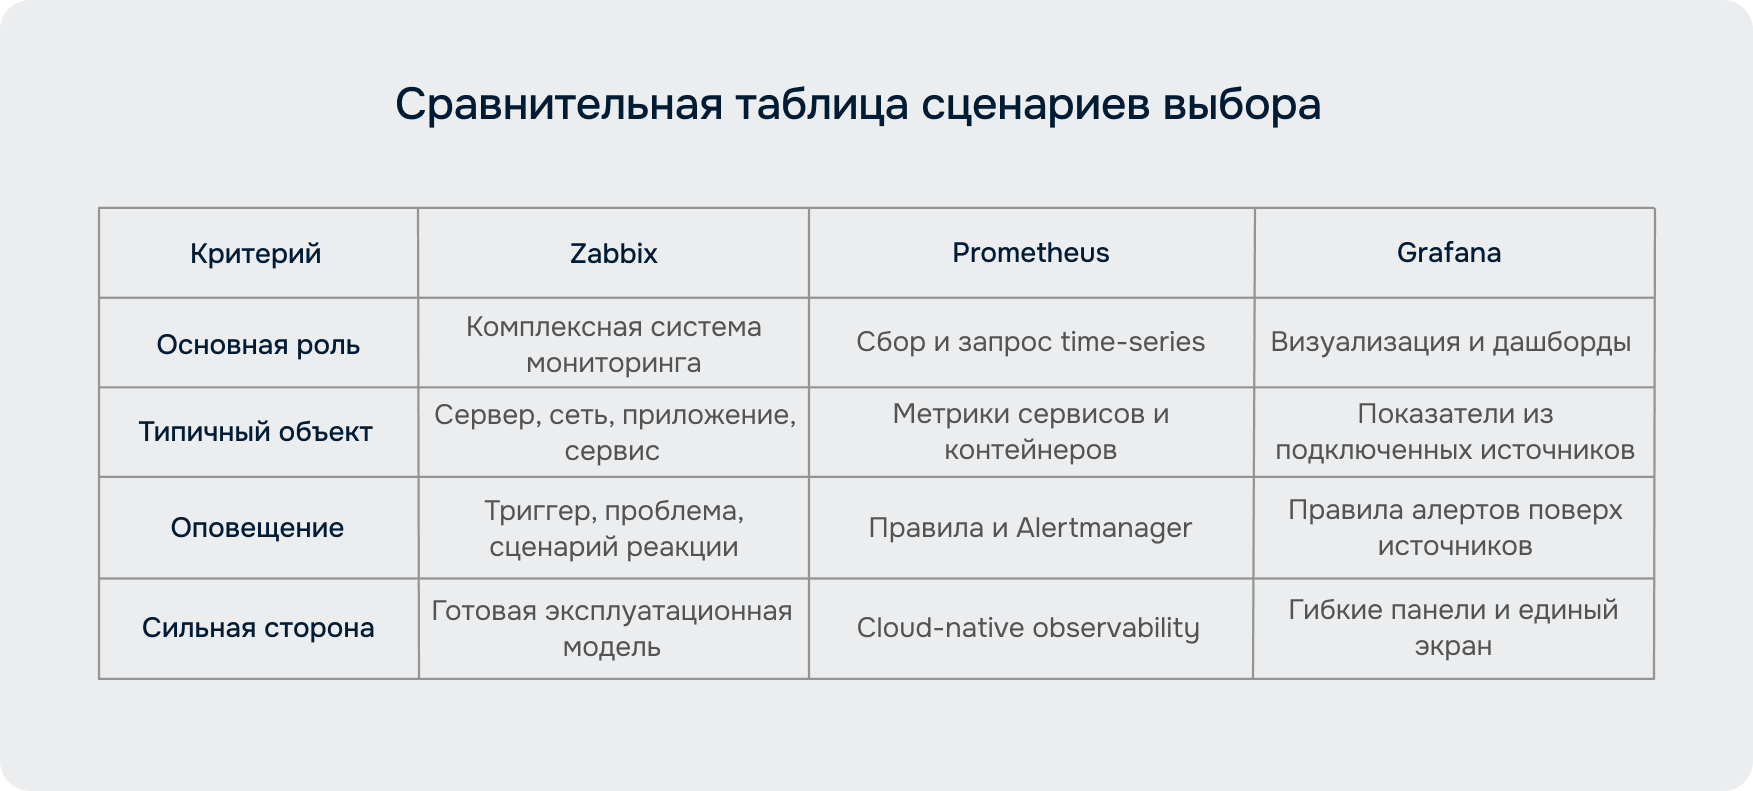
Zabbix и Prometheus пересекаются в сборе метрик и правилах алертов, но Prometheus ориентирован на time-series и pull-модель, популярную в cloud-native средах. Сравнение Zabbix и Prometheus показывает, что первый предлагает готовую модель хостов, шаблонов, сетевых проверок, алертов и автоматизации. Zabbix и Grafana сравнивать напрямую некорректно: Grafana прежде всего визуализирует показатели из разных источников. Связку Zabbix и Grafana используют, когда штатных панелей недостаточно.

Роли комплексного мониторинга, Prometheus и Grafana в контуре observability

Когда решение подходит компании

Решение уместно, если компании нужен единый мониторинг серверов, сетевого оборудования, приложений и услуг. Оно особенно полезно при разнородной инфраструктуре, филиалах и централизованной доставке сообщений. Перед внедрением фиксируют перечень сервисов, владельцев, целевые метрики и порядок реакции.

Начать лучше с пилота: выбрать критичный сервис, создать хосты и шаблоны, настроить триггеры, панель и каналы оповещения. После теста нагрузки и процедур дежурства систему расширяют. Такой подход показывает пользу быстрее, чем попытка сразу охватить каждую метрику.

Типичные ошибки при проектировании мониторинга

Собирать все без цели

Избыточная телеметрия увеличивает базу и затрудняет анализ. Для каждого элемента данных нужен ответ: какое решение он поддерживает, кто реагирует и сколько хранится история. Если метрика не влияет на реакцию, ее интервал или необходимость стоит пересмотреть.

Настраивать триггеры без контекста

Один порог для всех серверов создает ложные события. Триггер должен учитывать длительность, сезонность, зависимость от вышестоящего узла сети и важность сервиса. Корреляция событий помогает не отправлять десятки оповещений из-за одной сетевой аварии.

Забывать о платформе мониторинга

Нужно контролировать очередь, процессы центрального сервера, состояние proxy, объем БД и задержку получения значений. Без такого внутреннего мониторинга система может молчать не потому, что инфраструктура здорова, а потому, что агент или сервер перестал принимать телеметрию.

Не проверять уведомления

Тестовый сигнал должен пройти всю цепочку: триггер, правило реакции, уведомление, подтверждение и эскалацию. Контакты, webhook и интеграцию с ITSM проверяют после изменений. Иначе красивый экран не гарантирует, что оповещение дойдет до дежурного.

Вывод

Что такое Zabbix в прикладном смысле — это единый контур наблюдения и реакции. Система мониторинга Zabbix собирает телеметрию через агент, прокси и безагентные проверки, превращает метрики в события и показывает результат в веб-интерфейсе. Если заранее определить объекты, шаблоны, правила, SLA и ответственных, решение помогает быстрее обнаруживать проблемы и управлять производительностью ИТ-инфраструктуры.

Автор: Редакция Nubes


Источники: